

Pipelining: Durchsatz, Hazards und Speedup
Du lernst, wie eine Befehlspipeline arbeitet, wie du ihren Zeitgewinn berechnest und wie Konflikte entstehen und gemindert werden.
Kurz gesagt
Pipelining überlappt die Bearbeitung mehrerer Befehle im Prozessor, der Recheneinheit eines Computers. Das kann den Durchsatz erhöhen, also die Zahl fertiger Befehle pro Zeit. Konflikte heißen Hazards; der Speedup ist der Zeitbedarf ohne Pipeline geteilt durch den mit Pipeline im erklärten Vergleich.
Ein Maschinenbefehl ist eine einzelne Arbeitsanweisung für den Prozessor. Eine Befehlspipeline zerlegt ihre Bearbeitung in Stufen, ähnlich wie ein Fließband. Du untersuchst zuerst einen vereinfachten Ablauf ohne Wartezeiten und danach mögliche Konflikte.
Deine Lernziele
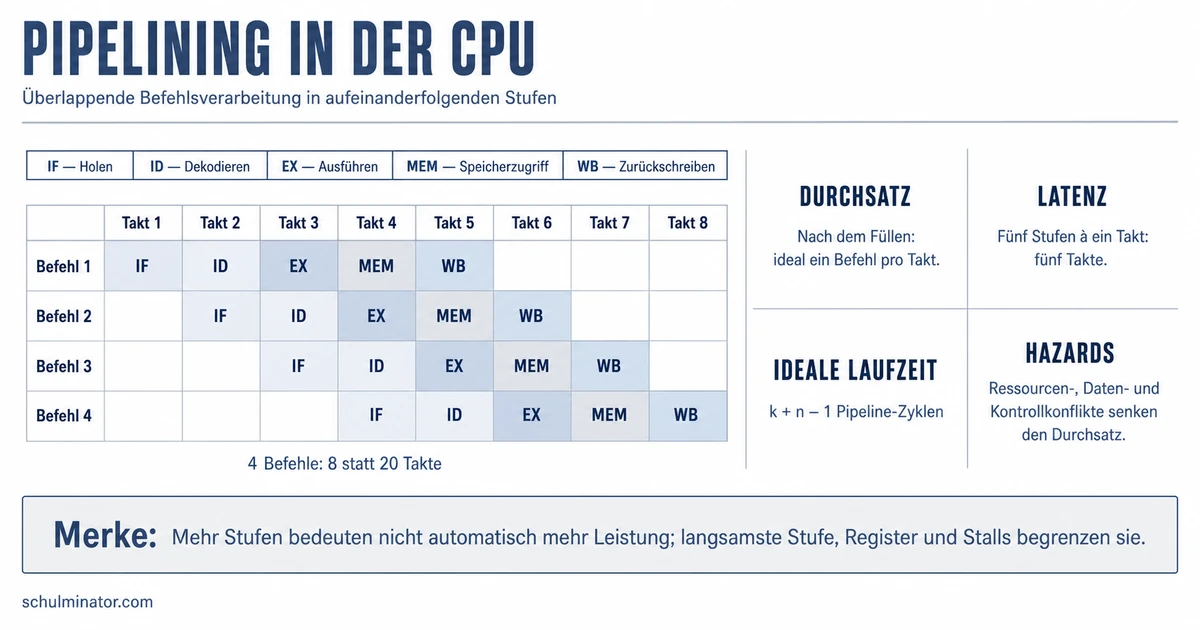
Eine Befehlspipeline teilt die Bearbeitung eines Befehls in aufeinanderfolgende Teilaufgaben. Jede Teilaufgabe gehört zu einer Stufe. Ein Takt ist hier ein gleich langer Zeitschritt. In unserem vereinfachten Modell benötigt jede Stufe einen Takt. Ein Befehl durchläuft die Stufen nacheinander und befindet sich in jedem Takt in einer Stufe.
Verschiedene Stufen können gleichzeitig verschiedene Befehle bearbeiten. Während ein Befehl die zweite Stufe nutzt, kann der nächste schon in der ersten Stufe beginnen. Die Arbeitsschritte eines einzelnen Befehls bleiben dabei erhalten.
Der Durchsatz beschreibt die Zahl fertig bearbeiteter Befehle pro Zeit. Im Idealmodell ohne Wartezeiten beginnt in jedem Takt ein neuer Befehl. Nachdem die Pipeline gefüllt ist, wird in jedem Takt ein Befehl fertig. Ein einzelner Befehl braucht trotzdem so viele Takte, wie die Pipeline Stufen hat. Seine Zeit vom Eintritt bis zum Abschluss heißt Latenz. Mehr Durchsatz bedeutet daher keine entsprechend kürzere Latenz eines einzelnen Befehls.
Pipelining
Mehrere Befehle werden zeitlich überlappend bearbeitet. Sie nutzen dabei verschiedene Stufen derselben Befehlspipeline.
Beispiel: Drei Befehle in einem ausgedachten Modell
- 1Das Modell hat die drei Stufen A, B und C. Jede Stufe braucht einen Takt; Wartezeiten treten nicht auf.
- 2Takt 1: Befehl U ist in A.
- 3Takt 2: U ist in B, V ist in A.
- 4Takt 3: U ist in C und endet danach; V ist in B, W ist in A.
- 5Takt 4: V ist in C und endet danach; W ist in B.
- 6Takt 5: W ist in C und endet danach. Jeder Befehl hat drei Takte gebraucht.
Teste dich
Wir rechnen mit einem Idealmodell: Die Pipeline ist anfangs leer. Jede Stufe braucht gleich viel Zeit. Pro Takt kann ein neuer Befehl beginnen. Es gibt keine Wartezeiten und keinen zusätzlichen Zeitbedarf beim Übergang zwischen Stufen. Die Stufenzahl heißt k, die Zahl der Befehle heißt n. Beide sind ganze Zahlen ab eins. Die Taktzeit heißt \tau; den griechischen Buchstaben sprichst du „tau“. Eine Nanosekunde, kurz ns, ist ein Milliardstel einer Sekunde.
Die Pipeline-Laufzeit heißt T_{\mathrm{P}}. Der erste Befehl benötigt k Takte. Die übrigen n-1 Befehle werden jeweils einen Takt später fertig. Deshalb gilt T_{\mathrm{P}}=(k+n-1)\cdot\tau. Für den Vergleich ohne Pipeline nehmen wir ausdrücklich an: Ein Befehl braucht k\cdot\tau, und die Befehle werden nacheinander bearbeitet. Diese Vergleichslaufzeit heißt T_{\mathrm{ohne}}. Es gilt T_{\mathrm{ohne}}=n\cdot k\cdot\tau.
Der Speedup S ist der Beschleunigungsfaktor gegenüber diesem Vergleich. Du teilst die Laufzeit ohne Pipeline durch die Laufzeit mit Pipeline: S=\frac{T_{\mathrm{ohne}}}{T_{\mathrm{P}}}=\frac{n\cdot k}{k+n-1}. Der Speedup hat keine Einheit. Beispielsweise bedeutet S=2: Mit Pipeline braucht die gleiche Befehlsfolge halb so viel Zeit.
Bei einem einzigen Befehl ist S=1. Es gibt dann keine Überlappung mit weiteren Befehlen. Bei mehr als einer Stufe bleibt der ideale Speedup für jede endliche Befehlszahl unter k. Bei immer längeren Befehlsfolgen nähert er sich k. Das ist eine Aussage über dieses Modell. In echten Prozessoren lässt sich die Taktzeit nicht beliebig verkürzen. Mehr Stufen benötigen außerdem mehr technische Bauteile und können die Zeitverluste durch Konflikte vergrößern.
Beispiel: Sieben Befehle durch vier Stufen
- 1Ausgedachte Werte für das Idealmodell: k=4, n=7 und \tau=3\,\mathrm{ns}.
- 2Die Pipeline benötigt 4+7-1=10 Takte. Damit ist T_{\mathrm{P}}=10\cdot3\,\mathrm{ns}=30\,\mathrm{ns}.
- 3Ohne Pipeline ergibt der festgelegte Vergleich T_{\mathrm{ohne}}=7\cdot4\cdot3\,\mathrm{ns}=84\,\mathrm{ns}.
- 4Der Speedup beträgt S=\frac{84}{30}=2{,}8.
Merke: Die Stufenzahl ist nicht automatisch der Speedup. Bei kurzen Befehlsfolgen fällt die anfängliche Füllzeit stark ins Gewicht.
Teste dich
Ein Konflikt in einer Pipeline heißt auch Hazard. Er kann die geplante überlappende Bearbeitung behindern. Zum Erkennen fragst du: Fehlt ein gemeinsam genutzter Baustein, ein benötigter Wert oder die Klarheit über den nächsten Befehl?
Ein Ressourcenkonflikt entsteht, wenn zwei Stufen gleichzeitig dieselbe begrenzt verfügbare Ressource benötigen. Eine Ressource ist hier etwa ein Rechenbaustein oder ein Zugang zum Speicher. Auch wenn die benötigten Werte bereitstehen, können zwei gleichzeitige Zugriffe auf einen einzigen solchen Baustein unmöglich sein.
Ein Datenkonflikt entsteht, wenn ein Befehl einen benötigten Wert noch nicht verwenden kann. Beispielsweise soll er das Ergebnis eines vorherigen Befehls benutzen, doch dieses Ergebnis steht noch nicht bereit. Freie Rechenbausteine allein beheben diesen fehlenden Wert nicht.
Ein Kontrollflusskonflikt betrifft die Frage, welcher Befehl als Nächstes ausgeführt werden soll. Der Kontrollfluss ist die Reihenfolge der ausgeführten Befehle. Ein bedingter Sprung setzt die Bearbeitung abhängig von einer Prüfung an einer anderen Stelle fort oder lässt sie an der bisherigen Stelle weiterlaufen. Solange die richtige Fortsetzung unklar ist, besteht ein Kontrollflusskonflikt.
Ein Konflikt kann Wartezyklen verursachen. Das Warten eines Befehls heißt Stall. Eine dadurch entstehende Lücke in der Bearbeitung heißt Bubble, auf Deutsch „Blase“. Solche Lücken senken den Durchsatz gegenüber dem Idealmodell. Nicht jeder erkannte Konflikt muss zu einem Stall führen: Eine passende Gegenmaßnahme kann ihn rechtzeitig beheben oder seine Folgen mindern.
| Konfliktart | Entscheidendes Problem | Ausgedachter Fall |
|---|---|---|
| Ressourcenkonflikt | Ein gemeinsam benötigter Baustein ist belegt. | Zwei Stufen brauchen im selben Takt den einzigen Zugang zum Speicher. |
| Datenkonflikt | Ein benötigter Wert steht noch nicht bereit. | Ein Befehl wartet auf die noch nicht berechnete Summe seines Vorgängers. |
| Kontrollflusskonflikt | Die richtige Fortsetzung ist unklar. | Bei einem bedingten Sprung ist noch offen, an welcher Stelle es weitergeht. |
Teste dich
Gegenmaßnahmen müssen zum Konflikt passen. Ein zusätzlicher passender Baustein kann einen Ressourcenkonflikt beheben, wenn dadurch die gleichzeitig benötigte Leistung bereitsteht. Er erzeugt jedoch keinen noch fehlenden Ergebniswert und entscheidet keinen unklaren Sprung.
Forwarding bedeutet hier direktes Weiterreichen eines bereits verfügbaren Ergebnisses an die Stufe, die es benötigt. Das Ergebnis kann genutzt werden, bevor der erzeugende Befehl seinen regulären Abschluss erreicht. So lassen sich viele Datenkonflikte ohne Warten beheben. Forwarding kann aber kein Ergebnis weiterreichen, das noch nicht berechnet ist. Steht der Wert auch über diesen direkten Weg nicht rechtzeitig bereit, kann weiterhin ein Stall nötig sein. Ein Ressourcenkonflikt wird durch das Weiterreichen allein ebenfalls nicht behoben.
Bei der Sprungvorhersage nimmt der Prozessor eine Fortsetzung an, bevor die Entscheidung über einen bedingten Sprung feststeht. Er arbeitet auf diesem angenommenen Weg vorläufig weiter. Das heißt spekulatives Weiterrechnen. Trifft die Vorhersage zu, kann dadurch Wartezeit vermieden werden.
Eine Vorhersage kann falsch sein. Dann müssen die zwischenzeitlich auf dem falschen Weg bearbeiteten Befehle verworfen werden. Diese Bereinigung heißt Pipeline-Flush. Die Arbeit auf dem falschen Weg kostet Zeit; bei langen Pipelines können solche Verluste besonders groß sein. Sprungvorhersage garantiert daher keine richtige Fortsetzung und keinen bestimmten Speedup. Sie liefert auch keinen fehlenden Datenwert und keinen zusätzlichen Rechenbaustein.
Beispiel: Ein Ergebnis direkt weiterreichen
- 1Ausgedachtes Modell: Befehl M berechnet 8+5=13. Befehl N soll danach dieses Ergebnis verdoppeln.
- 2Die Zahl 13 liegt bereits vor, obwohl M noch nicht regulär abgeschlossen ist. N benötigt den Wert jetzt.
- 3Ein passender direkter Weg reicht 13 an die benötigende Stufe weiter. N kann 13\cdot2=26 berechnen.
- 4Wäre das Ergebnis noch nicht berechnet, könnte Forwarding diesen fehlenden Wert nicht ersetzen.
Merke: Forwarding braucht ein bereits verfügbares Ergebnis. Sprungvorhersage braucht eine spätere Prüfung ihrer Annahme. Keine der beiden Maßnahmen beseitigt jede Konfliktart.
Teste dich
Alles auf einen Blick
Pipelining
Eine Pipeline überlappt die Bearbeitung verschiedener Befehle in verschiedenen Stufen.
Im gefüllten Idealmodell endet ein Befehl pro Takt; ein einzelner Befehl braucht weiterhin einen Takt je Stufe.
Bei anfangs leerer Pipeline, gleich langen Stufen und ohne zusätzliche Zeiten gilt mit Stufenzahl k, Befehlszahl n und Taktzeit \tau die Laufzeit T_{\mathrm{P}}=(k+n-1)\cdot\tau.
Gegenüber der festgelegten Vergleichslaufzeit n\cdot k\cdot\tau beträgt der ideale Beschleunigungsfaktor S=\frac{n\cdot k}{k+n-1}.
Eine belegte Ressource, ein fehlender Datenwert oder eine unklare Fortsetzung können Wartezeiten verursachen.
Zusätzliche Bausteine können Ressourcenengpässe beheben, Forwarding kann verfügbare Werte weiterreichen und Sprungvorhersage kann Wartezeit mindern. Keine Maßnahme löst jedes Problem.
Laufzeit und Speedup für zehn Befehle berechnen
- 1Ausgedachte Aufgabe im erklärten Idealmodell: Die anfangs leere Pipeline hat k=3 Stufen. Sie verarbeitet n=10 Befehle mit der Taktzeit \tau=4\,\mathrm{ns}.
- 2Zähle die Takte: Der erste Befehl braucht drei Takte, die übrigen neun brauchen jeweils einen weiteren. Insgesamt sind das 3+10-1=12 Takte.
- 3Berechne die Pipeline-Laufzeit: T_{\mathrm{P}}=12\cdot4\,\mathrm{ns}=48\,\mathrm{ns}.
- 4Berechne die festgelegte Vergleichslaufzeit ohne Pipeline: T_{\mathrm{ohne}}=10\cdot3\cdot4\,\mathrm{ns}=120\,\mathrm{ns}.
- 5Teile die Vergleichslaufzeit durch die Pipeline-Laufzeit: S=\frac{120}{48}=2{,}5. Der ideale Beschleunigungsfaktor ist hier kleiner als die Stufenzahl.
Fehler finden
Fehler in Zeile 4Die letzte Zeile setzt fälschlich die Stufenzahl als Ergebnis ein. Richtig: S=\frac{72}{24}=3. Bei dieser endlichen Befehlsfolge bleibt der ideale Speedup unter vier.
Lückentext
Nach dem Füllen liefert die Pipeline unseres Idealmodells pro Takt . Alle benötigten Bausteine sind frei, aber ein Folgebefehl braucht den noch nicht berechneten Ergebniswert seines Vorgängers. Das beschriebene Problem ist ein . Bei einem einzigen Befehl und vier Stufen beträgt der Speedup im erklärten idealen Vergleich .