

Reguläre Sprache: Automaten, Ausdrücke und Beweise
Du lernst reguläre Sprachen kennen: Wortmengen, die ein Automat mit endlich vielen Zuständen genau erkennt.
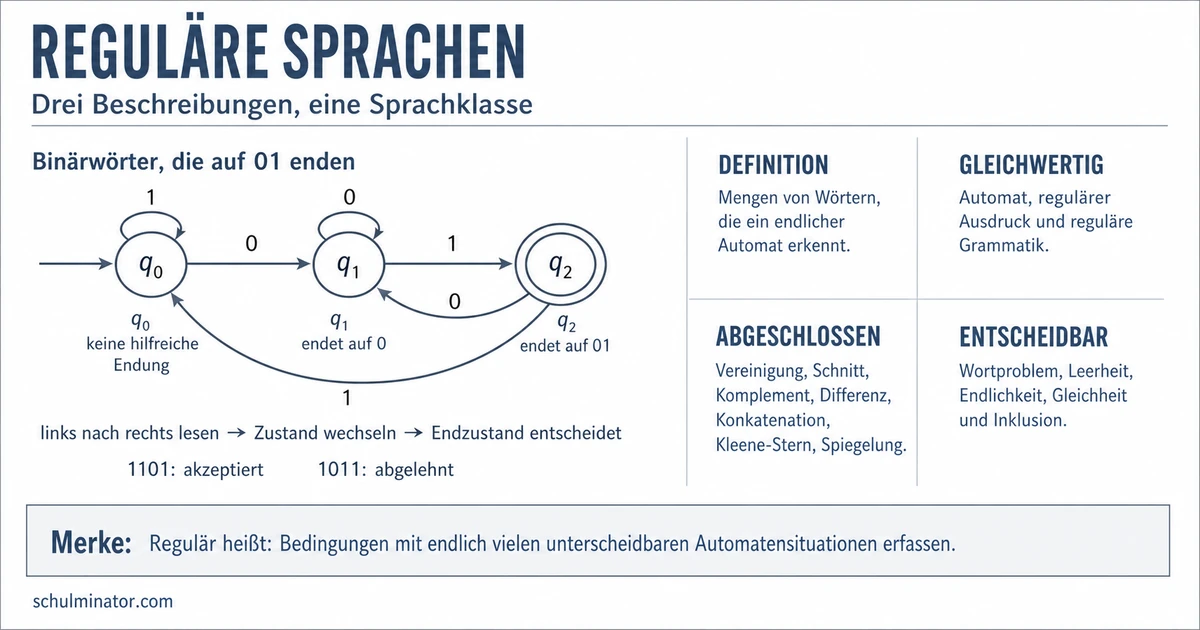
Kurz gesagt
Eine Sprache ist regulär, wenn ein endlicher Automat genau ihre Wörter erkennt. Gleichwertige Beschreibungen sind reguläre Ausdrücke als Formeln für Wortmuster und reguläre Grammatiken als Ersetzungsregeln.
In der Informatik kann schon eine Zeichenfolge wie „001“ ein Wort sein. Eine Sprache legt fest, welche Wörter dazugehören. Du beschreibst solche Wortmengen, prüfst einzelne Wörter und begründest, warum ein endlicher Automat manche Regeln nicht erkennen kann.
Deine Lernziele
Ein Alphabet ist eine endliche Menge erlaubter Zeichen. Der griechische Buchstabe \Sigma bezeichnet hier das Alphabet. Ein Wort ist eine endliche Folge dieser Zeichen. Das leere Wort \varepsilon enthält kein Zeichen. \Sigma^* bezeichnet die Menge aller Wörter über diesem Alphabet, einschließlich des leeren Wortes. Eine Sprache L ist eine Menge solcher Wörter. w\in L bedeutet: Das Wort w gehört zur Sprache L. Die Schreibweise |w| bezeichnet die Anzahl seiner Zeichen. Eine leere Sprache enthält kein Wort; eine Sprache mit dem leeren Wort ist dagegen nicht leer.
Eine Sprache heißt regulär, wenn ein endlicher Automat genau ihre Wörter erkennt: Er nimmt jedes zugehörige Wort an und lehnt jedes andere Wort über dem Alphabet ab. Ein endlicher Automat besitzt eine feste, endliche Menge von Zuständen. Ein Zustand beschreibt seine aktuelle Situation und bildet seinen gesamten veränderlichen Speicher. Trotzdem kann der Automat unendlich viele verschiedene Wörter erkennen, denn Zustände können mehrfach besucht werden.
Drei Beschreibungen sind gleichwertig: ein endlicher Automat, ein regulärer Ausdruck und eine reguläre Grammatik. Ein regulärer Ausdruck ist eine Formel, die erlaubte Wortmuster beschreibt. Ein Stern hinter einem Zeichen erlaubt beliebig viele Wiederholungen, auch null. Nebeneinanderstehende Teile werden aneinandergehängt. Eine reguläre Grammatik erzeugt Wörter durch eine endliche Liste von Ersetzungsregeln. Dafür genügen Regeln, die einen Platzhalter durch ein Zeichen, durch ein Zeichen mit folgendem Platzhalter oder durch das leere Wort ersetzen. Ein Automat oder eine solche Beschreibung muss die ganze Sprache erfassen. Einige passende Testwörter allein beweisen das nicht.
Reguläre Sprache
Eine Sprache ist regulär, wenn ein Automat mit endlich vielen Zuständen genau ihre Wörter erkennt. Gleichwertig kannst du sie durch einen regulären Ausdruck oder eine reguläre Grammatik beschreiben.
Beispiel: Wörter aus r und z beschreiben
- 1Das Alphabet besteht aus den Zeichen r und z. Gesucht sind beliebig viele r, gefolgt von genau einem z.
- 2Der reguläre Ausdruck lautet r^*z. Dazu gehören „z“, „rz“ und „rrz“, aber weder „zr“ noch „rr“.
- 3Für eine reguläre Grammatik sei S der Startplatzhalter. Der Pfeil bedeutet „ersetze durch“. Die Regeln lauten S\to rS und S\to z.
- 4Beispielsweise entsteht S\to rS\to rrS\to rrz. Der Platzhalter wird am Ende durch z ersetzt.
- 5Weil beliebig viele r erlaubt sind, enthält diese reguläre Sprache unendlich viele Wörter.
Teste dich
Ein deterministischer endlicher Automat, kurz DEA, liest ein Wort Zeichen für Zeichen von links nach rechts. Deterministisch bedeutet: Der aktuelle Zustand und das nächste Zeichen legen den Folgezustand eindeutig fest. Ein vollständiger DEA hat für jeden Zustand und jedes Zeichen einen Übergang. Er beginnt im Startzustand. Erst nach dem letzten Zeichen entscheidet er: Ein akzeptierender Zustand bedeutet Annahme, jeder andere Zustand Ablehnung. Beim leeren Wort entscheidet daher bereits der Startzustand.
Wir verwenden das Alphabet \Sigma=\{0,1\}. Gesucht sind alle Wörter, in denen „01“ nicht als zusammenhängende Zeichenfolge vorkommt. Solche Wörter bestehen aus beliebig vielen Einsen, gefolgt von beliebig vielen Nullen. Der reguläre Ausdruck ist 1^*0^*. Beide Teile dürfen leer sein. Sobald nach einer Null eine Eins folgt, ist die verbotene Zeichenfolge entstanden.
Unser vollständiger DEA hat die Zustände s, t und f. Der Startzustand s bedeutet: Bisher wurden keine Zeichen oder ausschließlich Einsen gelesen. Der Zustand t bedeutet: Mindestens eine Null wurde gelesen, aber noch kein „01“. Beide Zustände akzeptieren. Der Zustand f bedeutet: „01“ ist bereits vorgekommen. Er akzeptiert nicht. Er ist ein Fangzustand: Jeder weitere Übergang bleibt in f. Spätere Zeichen können eine bereits vorgekommene Zeichenfolge nicht entfernen.
Die Tabelle legt alle Übergänge fest. Von s führen Einsen wieder nach s; die erste Null führt nach t. Weitere Nullen halten den Automaten in t. Eine Eins nach einer Null führt nach f. Diese Bedeutungen bleiben nach jedem gelesenen Zeichen erhalten. Deshalb nimmt der Automat genau die Wörter ohne „01“ an. Die Tabelle beschreibt ein mathematisches Modell, kein ausführbares Programm.
| Zustand | Folgezustand bei „0“ | Folgezustand bei „1“ |
|---|---|---|
| s: Start, akzeptierend | t | s |
| t: akzeptierend | t | f |
| f: nicht akzeptierend | f | f |
Beispiel: Das Wort „001“ prüfen
- 1Starte in s.
- 2Die erste Null führt nach t. Die zweite Null lässt den Zustand t unverändert.
- 3Die folgende Eins führt nach f. Die Pfeile zeigen die Zustandsfolge: s\to t\to t\to f.
- 4Der letzte Zustand f akzeptiert nicht. Das Wort wird abgelehnt; seine letzten beiden Zeichen bilden „01“.
Merke: Ein Besuch in einem akzeptierenden Zustand reicht nicht. Für die Annahme zählt der Zustand nach dem ganzen Wort. Aus f gibt es bei diesem DEA keinen Rückweg.
Teste dich
Seien A und B reguläre Sprachen über demselben Alphabet \Sigma. Eine Abschlusseigenschaft bedeutet: Aus regulären Sprachen entsteht durch die betreffende Operation wieder eine reguläre Sprache. Bei der Vereinigung genügt die Zugehörigkeit zu mindestens einer der beiden Sprachen, also auch zu beiden. Beim Durchschnitt muss ein Wort zu beiden gehören. Das Komplement enthält genau die Wörter aus \Sigma^*, die nicht zur ursprünglichen Sprache gehören. Das Alphabet bleibt dabei fest. Der Überstrich in \overline{A} bezeichnet das Komplement; das Zeichen \setminus bedeutet „ohne die Elemente der folgenden Menge“.
Auch drei weitere Operationen erhalten die Regularität. Die Konkatenation AB bedeutet Aneinanderhängen: Ein Wort aus A wird von einem Wort aus B gefolgt. Der Kleene-Stern A^* erlaubt das Aneinanderhängen beliebig vieler Wörter aus A, einschließlich null Wörtern; so entsteht auch \varepsilon. Die Differenz A\setminus B enthält die Wörter, die zu A, aber nicht zu B gehören.
Für Vereinigung und Durchschnitt kannst du zwei vollständige DEA gleichzeitig nachführen. Ein Zustand des neuen Automaten ist ein Paar ihrer Zustände. Jedes Eingabezeichen wird von beiden verarbeitet. Für die Vereinigung akzeptiert ein Paar, wenn mindestens einer der beiden Zustände akzeptiert. Für den Durchschnitt müssen beide akzeptieren. Weil beide Zustandsmengen endlich sind, gibt es auch endlich viele Paare. Für das Komplement vertauschst du bei einem vollständigen DEA akzeptierende und nicht akzeptierende Zustände. Die Vollständigkeit ist nötig, damit jedes Wort einen Endzustand erreicht, dessen Entscheidung umgekehrt wird.
Ein Entscheidungsproblem ist eine Ja-oder-Nein-Frage mit einer beliebigen zulässigen Eingabe. Entscheidbar heißt: Ein festes Rechenverfahren liefert für jede solche Eingabe nach endlich vielen Schritten die richtige Antwort. Beim Wortproblem sind eine Sprachbeschreibung und ein Wort gegeben. Gefragt ist, ob das Wort zur Sprache gehört. Mit einem DEA liest du das ganze Wort und prüfst den erreichten Zustand. Das Leerheitsproblem fragt, ob die Sprache kein Wort enthält. Das Schnittproblem fragt, ob zwei Sprachen kein gemeinsames Wort haben. Das Endlichkeitsproblem fragt nach endlich vielen Wörtern. Das Äquivalenzproblem fragt, ob zwei Beschreibungen dieselbe Sprache erkennen. Das Inklusionsproblem fragt, ob jedes Wort der ersten Sprache auch zur zweiten gehört. Für gegebene reguläre Sprachen sind alle diese Probleme entscheidbar.
| Operation | Bedeutung | Ergebnis |
|---|---|---|
| Vereinigung A\cup B | Wörter aus mindestens einer der beiden Sprachen | regulär |
| Durchschnitt A\cap B | Wörter, die zu beiden Sprachen gehören | regulär |
| Komplement \overline{A}=\Sigma^*\setminus A | Wörter über dem festen Alphabet, die nicht zu A gehören | regulär |
Beispiel: Zwei Wortregeln verknüpfen
- 1Über dem Alphabet aus x und y enthalte A die Wörter mit letztem Zeichen x. B enthalte die Wörter mit gerader Zeichenanzahl.
- 2Beide Sprachen sind regulär: Ein DEA kann das letzte Zeichen speichern; ein anderer kann zwischen gerader und ungerader Zeichenanzahl wechseln.
- 3Das Wort „yxx“ gehört zu A, denn es endet mit x. Es gehört nicht zu B, denn es hat drei Zeichen.
- 4Damit gehört „yxx“ zur Vereinigung, aber nicht zum Durchschnitt.
Merke: Das Komplement hängt vom festgelegten Alphabet ab. Beim Vertauschen der akzeptierenden Zustände muss der DEA vollständig sein.
Teste dich
Das Pumping-Lemma ist ein bewiesener Hilfssatz über das Wiederholen von Wortteilen. Ist eine Sprache L regulär, gibt es eine feste ganze Zahl n\ge1, die Pumping-Länge. Für jedes Wort h\in L mit |h|\ge n gibt es eine Zerlegung in drei Teilwörter h=uvw. Dabei gilt |uv|\le n und |v|>0. Außerdem muss uv^iw für jede ganze Zahl i\ge0 wieder zu L gehören. v^i bedeutet: Der Teil v wird i-mal aneinandergehängt. Bei i=0 fällt er weg, bei i=1 bleibt er einmal stehen und bei i=2 steht er zweimal da.
Die Idee kommt von einem DEA mit endlich vielen Zuständen. Hat er n Zustände, besucht er beim Lesen der ersten n Zeichen zusammen mit dem Startzustand n + 1 Zustände. Mindestens ein Zustand wird also erneut besucht. Der dazwischen gelesene, nichtleere Wortteil führt zum selben Zustand zurück. Diesen Weg kannst du weglassen oder wiederholen, ohne die anschließende Verarbeitung zu ändern. Das erklärt die Wiederholungsbedingung.
Für einen Beweis der Nichtregularität nimmst du zunächst an, die Sprache sei regulär. Dann ist eine Pumping-Länge n vorgegeben; du darfst sie nicht später an eine Zerlegung anpassen. Du wählst ein geeignetes Wort mit mindestens n Zeichen. Nun musst du jede Zerlegung ausschließen, die |uv|\le n und |v|>0 erfüllt. Eine einzelne ungünstige Zerlegung reicht nicht: Das Lemma verlangt die Existenz einer geeigneten Zerlegung, nicht die Eignung jeder Zerlegung.
Unsere Sprache L besteht aus den Wörtern a^m b^m für ganze Zahlen m\ge0. Das bedeutet: zuerst m Zeichen a, danach genau m Zeichen b. Für m=0 gehört das leere Wort dazu. Die folgende allgemeine Rechnung zeigt, dass diese Sprache nicht regulär ist.
Beispiel: Den Widerspruch für gleich große Zeichenblöcke herleiten
- 1Angenommen, L wäre regulär. Dann gäbe es eine Pumping-Länge n\ge1.
- 2Wähle h=a^n b^n. Dieses Wort gehört zu L und hat die Länge 2n, also mindestens n Zeichen.
- 3Betrachte eine beliebige Zerlegung h=uvw mit |uv|\le n und |v|>0. Die ersten n Zeichen sind a. Deshalb besteht v aus k Zeichen a, wobei 1\le k\le n gilt.
- 4Wähle i=2. Der wiederholte Teil fügt k Zeichen a hinzu. Es entsteht uv^2w=a^{n+k}b^n.
- 5Wegen k\ge1 enthält dieses Wort mehr a als b und gehört nicht zu L.
- 6Das scheitert für jede zulässige Zerlegung. Es widerspricht dem Pumping-Lemma; daher ist L nicht regulär.
Merke: Jede reguläre Sprache erfüllt das Pumping-Lemma. Die Umkehrung gilt nicht: Auch manche nicht regulären Sprachen erfüllen es. Du kannst damit Nichtregularität beweisen, aber Regularität nicht allein durch das Erfüllen des Lemmas nachweisen.
Teste dich
Alles auf einen Blick
Reguläre Sprache
Ein endlicher Automat erkennt genau die Wörter der Sprache; die Wortmenge darf unendlich sein.
Endliche Automaten, reguläre Ausdrücke und reguläre Grammatiken beschreiben dieselbe Klasse von Sprachen.
Ein DEA liest das ganze Wort; der danach erreichte Zustand entscheidet über Annahme oder Ablehnung.
Vereinigung, Durchschnitt, Komplement, Konkatenation, Kleene-Stern und Differenz erhalten die Regularität.
Für den Gegenbeweis musst du jede zulässige Zerlegung ausschließen; das Erfüllen des Lemmas beweist keine Regularität.
Das Wort „10010“ mit dem DEA prüfen
- 1Verwende den vollständigen DEA für Wörter ohne „01“ über dem Alphabet aus 0 und 1. Starte in s.
- 2Die erste Eins führt von s nach s.
- 3Die erste Null führt nach t; die zweite Null lässt den Zustand t unverändert.
- 4Die nächste Eins führt von t nach f. Damit ist „01“ vorgekommen.
- 5Die letzte Null lässt den Zustand f unverändert. Insgesamt ergibt sich s\to s\to t\to t\to f\to f.
- 6Der Endzustand f akzeptiert nicht. Deshalb gehört „10010“ nicht zur Sprache.
Fehler finden
Fehler in Zeile 3Der Übergang bei einer Null aus f ist falsch angegeben. Richtig: Die nächste Null führt von f nach f. Eine bereits gelesene Zeichenfolge „01“ bleibt Teil des Wortes.
Lückentext
Beim DEA für Wörter ohne „01“ endet der Durchlauf für „110“ in . Bei zwei regulären Sprachen umfasst der Durchschnitt die Wörter, die zu der beiden Sprachen gehören. Im Pumping-Beweis für a^n b^n gilt |uv|\le n und |v|>0. Der Teil v besteht deshalb aus .