

Reguläre Ausdrücke verstehen und anwenden
Du baust Suchmuster aus Zeichen und Wiederholungen und prüfst, ob ein Ausschnitt oder die ganze Eingabe passt.
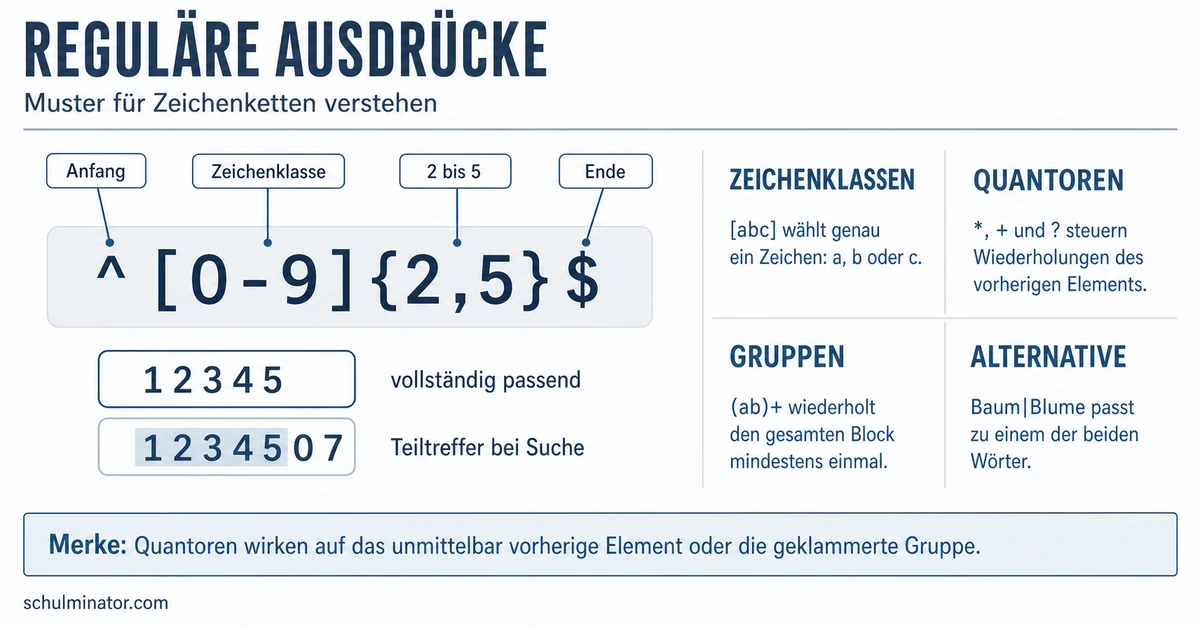
Kurz gesagt
Ein regulärer Ausdruck beschreibt, welche Zeichenfolgen zu einem Muster passen. Du kannst damit einen passenden Ausschnitt suchen oder verlangen, dass die ganze Eingabe passt.
Eine Zeichenkette ist eine Folge von Zeichen, etwa „K4“. Ein regulärer Ausdruck, kurz Regex, ist ein Muster für Zeichenketten. Wir nutzen die Schreibweise der Programmiersprache JavaScript. Du lernst, Muster zu bauen, Treffer zu begründen und ihre theoretische Grundlage zu erklären.
Deine Lernziele
Wir schreiben JavaScript-Muster zwischen Schrägstrichen, etwa /uv/. Die Schrägstriche begrenzen das Muster und gehören nicht zum gesuchten Text. Wir verwenden zunächst keine Zusatzkennzeichen, auch Flags genannt. Solche Kennzeichen können das Suchverhalten ändern. Hier muss die Groß- und Kleinschreibung übereinstimmen. Alle Beispiel-Eingaben bestehen aus einer Zeile ohne Zeilenumbruch.
Ein Literal steht für das Zeichen selbst. Im Muster /uv/ sind „u“ und „v“ Literale: Gesucht ist die zusammenhängende Folge „uv“. Eine Zeichenklasse in eckigen Klammern steht dagegen für genau ein Zeichen aus einer Auswahl. [KR] erlaubt „K“ oder „R“. [0-9] erlaubt eine Ziffer von 0 bis 9; der Bindestrich bezeichnet hier den Bereich.
Ein Quantor gibt an, wie oft der direkt vorhergehende Baustein vorkommen darf. Er gilt für ein einzelnes Zeichen, eine Zeichenklasse oder eine geklammerte Gruppe. Die Tabelle zeigt die Schreibweisen am Zeichen „p“. Für null oder mehr Wiederholungen schreiben wir hier {0,}. Beim Sternquantor steht stattdessen das Sternzeichen unmittelbar hinter dem Baustein. Beide Schreibweisen sind gleichwertig und erlauben dieselben passenden Teilstücke.
Eine Gruppe fasst Bausteine mit runden Klammern zusammen. Bei /(te){2}/ wird die ganze Folge „te“ zweimal verlangt. Das Zeichen | trennt Alternativen: /(JA|NE)/ erlaubt die Folge „JA“ oder die Folge „NE“. Bei jeder Wiederholung einer Zeichenklasse darf ein anderes Zeichen gewählt werden. Auch bei einer wiederholten Gruppe mit Alternativen darf die Wahl wechseln: /(ha|ho){2}/ erlaubt etwa „haho“. Die Muster dieses Abschnitts suchen passende Teilstücke; davor und danach darf weiterer Text stehen.
Quantor
Ein Quantor legt die erlaubte Anzahl von Wiederholungen des vorhergehenden Bausteins fest. Eine Gruppe macht mehrere Zeichen zu einem gemeinsamen Baustein.
| Schreibweise | Bedeutung für das Zeichen „p“ |
|---|---|
| /p{3}/ | Genau dreimal. |
| /p{2,4}/ | Mindestens zweimal, höchstens viermal. |
| /p{2,}/ | Mindestens zweimal, ohne feste Obergrenze. |
| /p?/ | Nullmal oder einmal; gleichwertig zu /p{0,1}/. |
| /p+/ | Mindestens einmal; gleichwertig zu /p{1,}/. |
| /p{0,}/ | Nullmal oder öfter; gleiche Bedeutung wie der Sternquantor. |
Beispiel: Ein erfundenes Suchmuster zusammensetzen
- 1Gesucht ist „RA“ oder „SI“, danach genau zwei Ziffern und anschließend null oder mehr Wiederholungen von „zo“.
- 2Die Bausteine ergeben /(RA|SI)[0-9]{2}(zo){0,}/.
- 3„RA47zozo“ passt: „RA“, die Ziffern „47“ und zweimal „zo“ erfüllen die Bausteine.
- 4„SI08“ passt ebenfalls: Nach den beiden Ziffern wird „zo“ nullmal verwendet.
Teste dich
Ein Teiltreffer ist ein passender zusammenhängender Ausschnitt der Eingabe. Ein Muster ohne Begrenzungen für Anfang und Ende kann einen solchen Ausschnitt finden. Deshalb verhindert eine längere Eingabe nicht automatisch einen Treffer. Die Zahl in einem Quantor begrenzt den passenden Baustein, nicht die Länge der gesamten Eingabe.
Anker legen eine Position fest, ohne selbst ein Zeichen zu verbrauchen. Ohne das Flag m steht der Anfangsanker ^ für den Anfang und der Endanker Dollarzeichen ($) für das Ende der Eingabe. Für eine Prüfung der gesamten Zeichenkette setzt du den Anfangsanker vor und den Endanker hinter das vollständige Muster. Bei Alternativen klammerst du die Auswahl ein: Für die Gesamtprüfung von „hi“ oder „ho“ steht die Gruppe (hi|ho) zwischen den beiden Ankern. In unseren einzeiligen Eingaben muss dann jedes Zeichen zum Muster gehören.
Das Flag m schaltet den mehrzeiligen Modus ein. Dann können die beiden Anker auch an Anfängen und Enden einzelner Zeilen passen. Ein Treffer zwischen diesen Ankern garantiert mit m deshalb keine Prüfung der gesamten mehrzeiligen Eingabe. Unsere Gesamtprüfungen verwenden kein m.
Beispiel: Ein erfundenes Kennzeichen im Text suchen
- 1Die Eingabe lautet „vorH734nach“.
- 2Das Muster /H[0-9]{2}/ trifft das Teilstück „H73“. Die weitere Ziffer „4“ verhindert diesen Teiltreffer nicht.
- 3Für die Gesamtprüfung setzen wir H[0-9]{2} zwischen Anfangs- und Endanker, ohne das Flag m. „vorH734nach“ passt nicht vollständig: Vor dem „H“ und nach den beiden Ziffern stehen weitere Zeichen.
- 4Die Eingabe „H73“ passt dagegen vollständig zu diesem Muster mit beiden Ankern.
Merke: Unterscheide die Fragen „Enthält die Eingabe ein passendes Teilstück?“ und „Passt die gesamte Eingabe?“. Für die zweite Frage verwenden wir Anfangs- und Endanker ohne das Flag m.
Teste dich
Prüfe zuerst, ob ein Teilstück gesucht oder die gesamte Eingabe geprüft wird. Zerlege dann das Muster in Bausteine. Suche eine zusammenhängende Zeichenfolge, die alle Bausteine in der verlangten Reihenfolge erfüllt. Beachte die Auswahl einer Zeichenklasse, die Wiederholungszahlen und die Groß- und Kleinschreibung.
Beim Muster /(mu|la){2}R?/ müssen zwei Folgen unmittelbar aufeinanderfolgen. Jede Folge darf „mu“ oder „la“ sein. Danach darf ein „R“ stehen, es muss aber nicht vorkommen. Ein einzelnes „mu“ reicht nicht für die zweimal verlangte Gruppe. Ein zusätzliches Zeichen zwischen den beiden Gruppenfolgen würde deren unmittelbare Folge unterbrechen.
Ein Muster kann auch null Zeichen treffen. Diese Folge ohne Zeichen heißt leere Zeichenkette oder leeres Wort. Zum Beispiel erlaubt /e{0,}/ null Wiederholungen von „e“. Es kann deshalb auch in „TUR“ einen leeren Treffer finden, obwohl dort kein „e“ steht. Bei der Gesamtprüfung mit Anfangs- und Endanker ohne das Flag m passt „TUR“ dagegen nicht zu e{0,}: Die vorhandenen Zeichen werden vom Muster nicht erfasst.
| Eingabe | Ergebnis für /(mu|la){2}R?/ | Begründung |
|---|---|---|
| „mulaR“ | Treffer: „mulaR“ | „mu“, „la“ und das erlaubte „R“ folgen aufeinander. |
| „xxlamuQ“ | Teiltreffer: „lamu“ | „la“ und „mu“ erfüllen die Gruppe zweimal. Das „R“ darf fehlen. |
| „muR“ | Kein Treffer | Die Gruppe kommt vor dem „R“ erst einmal vor. |
| „MUla“ | Kein Treffer | „MU“ passt nicht zu „mu“. Das verbleibende „la“ reicht nicht zweimal. |
Merke: Begründe einen Nichttreffer mit einem verletzten Baustein. Bei einer Suche ohne Anker genügt zusätzliche Länge allein nicht als Begründung.
Teste dich
In der Theorie heißt eine festgelegte endliche Zeichenmenge Alphabet. Ein Wort ist eine endliche Folge von Zeichen dieses Alphabets; auch die leere Zeichenkette zählt dazu. Eine formale Sprache ist eine Menge solcher Wörter. Ein theoretischer regulärer Ausdruck beschreibt eine solche Menge. Dabei geht es um ganze Wörter der Sprache. Die praktische Suche nach einem passenden Teilstück ist eine zusätzliche Suchaufgabe.
Theoretische reguläre Ausdrücke beruhen auf drei Operationen: Alternative wählt zwischen Ausdrücken, Verkettung setzt sie hintereinander und Wiederholung erlaubt null oder mehr Wiederholungen. Zeichenklassen und feste Wiederholungszahlen sind bequeme Kurzschreibweisen für passende Kombinationen dieser Operationen.
Ein endlicher Automat ist ein Modell mit einer festen endlichen Menge von Zuständen. Ein Zustand beschreibt die aktuelle Situation des Modells beim Lesen. Der Automat beginnt in einem Startzustand und liest ein Wort Zeichen für Zeichen. Übergangsregeln legen fest, welcher Zustand als Nächstes erreicht wird. Nach dem letzten Zeichen wird das Wort angenommen, wenn der erreichte Zustand als annehmend festgelegt ist. Die Zustandsmenge ist fest; längere Eingaben erzeugen keine zusätzlichen Zustände.
Zu jedem theoretischen regulären Ausdruck gibt es einen endlichen Automaten, der genau seine Sprache annimmt. Umgekehrt lässt sich die Sprache jedes endlichen Automaten durch einen theoretischen regulären Ausdruck beschreiben. Diese Gleichwertigkeit betrifft die beschreibbaren Sprachen, nicht eine gleiche Schreibweise oder einen gleichen Aufbau.
Praktische Suchsysteme können zusätzliche Funktionen anbieten. Eine Rückwärtsreferenz verlangt erneut genau den Text, den eine Gruppe zuvor innerhalb desselben Treffers erfasst hat. Solche Erweiterungen können Sprachen beschreiben, die nicht regulär sind. Deshalb gilt die Gleichwertigkeit mit endlichen Automaten nicht pauschal für alle erweiterten Suchmuster.
Reguläre Sprache
Eine reguläre Sprache ist eine Menge von Wörtern, die ein theoretischer regulärer Ausdruck beschreibt. Genau diese Sprachen können auch endliche Automaten annehmen.
| Aktueller Zustand | Nächster Zustand bei „r“ | Nächster Zustand bei „s“ |
|---|---|---|
| A | B | A |
| B | B | A |
Beispiel: Ein erfundenes Automatenmodell für Wörter mit Schlusszeichen „r“
- 1Das Alphabet besteht aus „r“ und „s“. A ist der Startzustand und nicht annehmend. B ist annehmend. Die Tabelle enthält die Übergangsregeln.
- 2Beim Wort „ssr“ bleibt das Modell nach dem ersten und zweiten „s“ in A. Nach „r“ erreicht es B und nimmt das Wort an.
- 3Nach jedem gelesenen „r“ steht das Modell in B, nach jedem „s“ in A. Deshalb nimmt es genau die Wörter an, die mit „r“ enden.
- 4Die leere Zeichenkette wird nicht angenommen, denn ohne gelesenes Zeichen bleibt das Modell in A.
- 5Mit unserer Wiederholungsschreibweise beschreibt (r|s){0,}r dieselbe Sprache: Zuerst dürfen beliebig viele Alphabetzeichen stehen, zuletzt muss „r“ folgen. Gemeint sind jeweils ganze Wörter.
Teste dich
Alles auf einen Blick
Regulärer Ausdruck
Literale stehen für sich selbst; eine Zeichenklasse wählt pro Verwendung genau ein Zeichen.
Ein Quantor gilt für den vorhergehenden Baustein. {0,} ist gleichwertig zum Sternquantor.
Runde Klammern fassen Bausteine zusammen; | trennt Alternativen.
Ohne Anker genügt ein Teiltreffer. Für unsere Gesamtprüfungen verwenden wir Anfangs- und Endanker ohne das Flag m.
Ein Muster wie /e{0,}/ kann passen, ohne ein Zeichen zu verbrauchen.
Reguläre Sprachen lassen sich durch theoretische reguläre Ausdrücke und endliche Automaten beschreiben; praktische Erweiterungen können darüber hinausgehen.
Ein Suchmuster für erfundene Produktkennzeichen bauen
- 1Gesucht ist ein Teilstück aus „P“ oder „T“, danach zwei bis drei Ziffern und abschließend einem oder mehreren „w“.
- 2Die Anfangsauswahl schreiben wir als Gruppe: (P|T).
- 3Für zwei bis drei Ziffern ergänzen wir [0-9]{2,3}.
- 4Für mindestens ein abschließendes „w“ ergänzen wir w+.
- 5Zusammen ergibt das /(P|T)[0-9]{2,3}w+/.
- 6In „vorT604wwnach“ passt das Teilstück „T604ww“: „T“, drei Ziffern und zwei „w“ erfüllen die Bausteine.
Fehler finden
Fehler in Zeile 3Die behauptete Gleichheit der Ziffern ist falsch. Richtig: {2} verlangt zwei Ziffern aus [25]; sie dürfen verschieden sein. Das Muster trifft „B52Z“.
Lückentext
Eine Zeichenklasse mit der Auswahl „U“ und „V“ trifft pro Verwendung aus ihrer Auswahl. Beim Muster /n{2,4}/ ist die Mindestanzahl unmittelbar aufeinanderfolgender „n“ . Die Suche ohne Anker nach „Q“ und genau zwei folgenden Ziffern findet in „vorQ59nach“ den Text .