

RISC einfach erklärt: Befehle und Pipelining
Du erklärst RISC, zerlegst Rechnungen in Laden, Rechnen und Speichern und erkennst Nutzen und Grenzen überlappender Befehlsverarbeitung.
Kurz gesagt
RISC steht für „Reduced Instruction Set Computer“, etwa „Rechner mit reduziertem Befehlssatz“; ein Befehlssatz ist die Menge verfügbarer Befehle. Pipelining überlappt die Verarbeitung mehrerer Befehle und kann ihren Durchsatz, also die Zahl fertiger Befehle pro Zeit, erhöhen.
Ein Prozessor ist ein Bauteil im Computer, das Befehle ausführt. Ein Register ist ein kleiner Speicherplatz direkt im Prozessor. Eine Prozessorarchitektur beschreibt unter anderem, welche Befehle und Speicherzugriffe ein Prozessor anbietet. Du untersuchst diese Regeln und ein vereinfachtes Modell für die zeitlich überlappende Verarbeitung von Befehlen.
Deine Lernziele
Ein Prozessorbefehl legt fest, welche Verarbeitung der Prozessor ausführen soll. Die Gesamtheit der verfügbaren Befehle heißt Befehlssatz. Ein Programm nutzt solche Befehle, um eine Aufgabe zu lösen.
RISC setzt als Architekturidee auf einfache Befehle, leicht erkennbare Befehlsformen und viele Register. Der Prozessor soll anhand der Befehlsform leicht erkennen können, was zu tun ist. Eine größere Aufgabe wird aus passenden Einzelschritten zusammengesetzt, statt möglichst viele Arbeitsschritte in einem Befehl zu bündeln.
„Reduziert“ legt keine feste Anzahl von Befehlen fest. Auch die Aussage, dass ein konkreter Prozessor schneller ist, folgt daraus nicht. Die Architekturidee beschreibt angebotene Funktionen und Regeln; ein konkreter Prozessor setzt sie technisch um.
RISC
Die Abkürzung steht für „Reduced Instruction Set Computer“, etwa „Rechner mit reduziertem Befehlssatz“. Die Grundidee sind einfache, leicht erkennbare Befehle und viele Register.
Merke: Bei RISC kommt es auf die Gestaltung der Befehle an. Der Name schreibt keine feste Befehlszahl vor und verspricht keine bestimmte Geschwindigkeit.
Teste dich
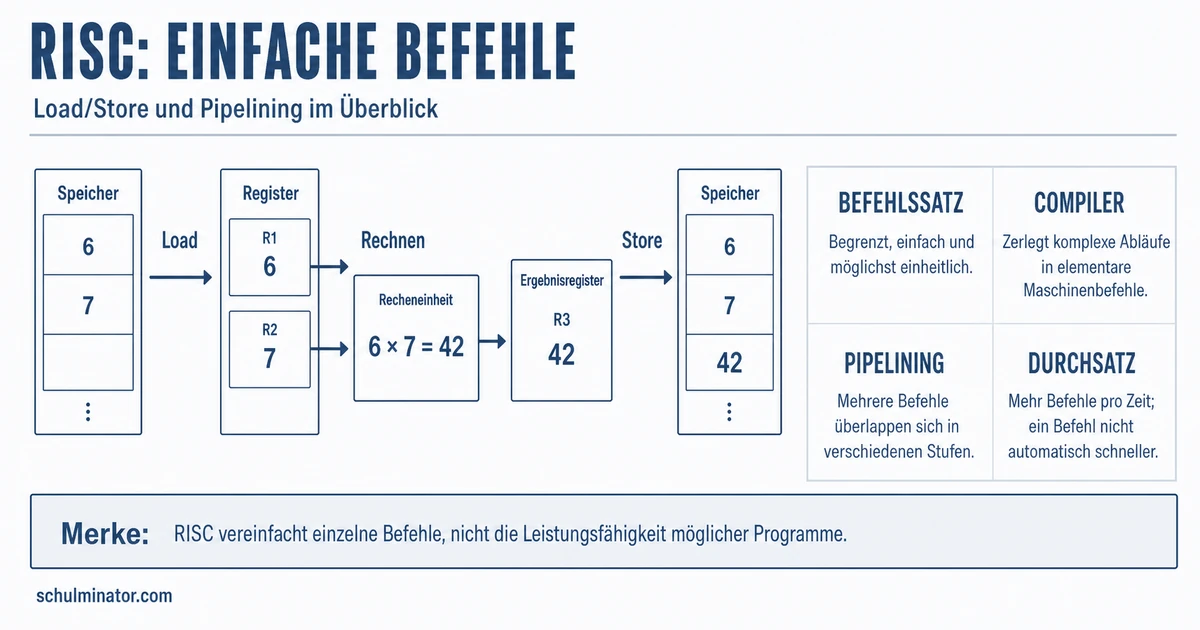
Load bedeutet „Laden“, Store bedeutet „Speichern“. Bei einer Load/Store-Architektur übertragen Lade- und Speicherbefehle Werte zwischen Datenspeicher und Registern. Mit Datenspeicher meinen wir hier die Speicherplätze für die verarbeiteten Daten, getrennt von den Registern. Rechenbefehle greifen nicht direkt auf diese Datenspeicherplätze zu: Werte von dort müssen zunächst in Registern bereitliegen. Diese Regel betrifft Datenzugriffe, nicht das Holen der Befehle selbst.
Wir verwenden ein erfundenes, vereinfachtes Rechenmodell. Es kann addieren, subtrahieren und multiplizieren. Seine Rechenbefehle nehmen ihre Zahlen aus Registern und legen das Ergebnis in einem Register ab. R1, R2 und R3 sind Registernamen. Jeder Lade- oder Speicherbefehl überträgt genau einen Wert. Die Abläufe beschreiben wir in Worten, nicht als ausführbaren Programmcode.
Liegen beide benötigten Zahlen im Datenspeicher und soll das Ergebnis wieder dort stehen, braucht unser Modell zwei Ladebefehle, einen Rechenbefehl und einen Speicherbefehl. Bereits geladene Werte müssen nicht erneut geladen werden. Soll das Ergebnis im Register bleiben, entfällt das anschließende Speichern.
Beispiel: Einen Restbestand im erfundenen Modell berechnen
- 1Im Datenspeicher stehen unter „Vorrat“ 18 und unter „Abgabe“ 5. Unter „Rest“ soll die Differenz stehen.
- 2Laden: Kopiere 18 aus „Vorrat“ in R1 und 5 aus „Abgabe“ in R2. Das sind zwei Ladebefehle.
- 3Rechnen: Subtrahiere R2 von R1 und lege das Ergebnis in R1 ab. Es gilt 18-5=13.
- 4Speichern: Kopiere 13 aus R1 nach „Rest“ im Datenspeicher.
Merke: Laden kopiert einen Wert in ein Register. Rechnen verarbeitet Registerwerte. Speichern kopiert einen Registerwert in den Datenspeicher. Welche Schritte nötig sind, hängt davon ab, wo Eingaben und Ergebnis liegen sollen.
Teste dich
CISC steht für „Complex Instruction Set Computer“, etwa „Rechner mit komplexem Befehlssatz“. Komplex bedeutet hier: Ein Befehl kann mehrere Arbeitsschritte bündeln und eine aufwendigere Befehlsform haben. RISC richtet den Entwurf stärker auf einfache Befehle und leicht erkennbare Befehlsformen aus. Das sind Grundideen, keine vollständigen Beschreibungen jedes heutigen Prozessors.
Die nach außen angebotenen Befehle und ihre innere Verarbeitung müssen getrennt betrachtet werden. Ein Prozessor kann einen CISC-Befehlssatz anbieten und Befehle intern in einfache Teilbefehle übersetzen. Einfache innere Schritte machen den äußeren Befehlssatz deshalb nicht zu RISC. Auch Pipelining, also die zeitlich überlappende Verarbeitung mehrerer Befehle, ist mit einem CISC-Befehlssatz vereinbar.
Aus den Bezeichnungen RISC und CISC folgt keine allgemeine Geschwindigkeitsrangfolge. Für einen Vergleich konkreter Prozessoren brauchst du weitere Angaben, etwa zur technischen Umsetzung und zur ausgeführten Aufgabe.
| Merkmal | RISC-Grundidee | CISC-Grundidee |
|---|---|---|
| Arbeit eines Befehls | Einfache Verarbeitungsschritte | Auch mehrere Arbeitsschritte gebündelt |
| Befehlsformen | Leicht für den Prozessor zu erkennen | Auch aufwendigere Formen vorgesehen |
Merke: Ein äußerer CISC-Befehlssatz kann mit einfachen inneren Schritten und Pipelining verbunden werden. Die Bezeichnung allein entscheidet keinen Geschwindigkeitsvergleich.
Teste dich
Beim Pipelining bearbeiten mehrere Stufen verschiedene Befehle gleichzeitig. Der Durchsatz gibt an, wie viele Befehle pro Zeit fertig werden. Durch die Überlappung kann der Durchsatz steigen. Die Zeit vom Beginn bis zum Ende eines einzelnen Befehls wird dadurch nicht automatisch kürzer.
Unser ideales Modell hat drei Stufen: Holen des Befehls, Bearbeiten und Abschließen. Die Folge dieser Stufen heißt Pipeline. Ein Takt ist hier ein gleich langer Zeitschritt des Prozessors. Jede Stufe braucht einen Takt und bearbeitet höchstens einen Befehl zugleich. Die Stufen nutzen getrennte Arbeitsmittel. Ab Takt 1 wird in jedem Takt ein neuer Befehl geholt, solange noch nicht begonnene Befehle anstehen. P und Q bezeichnen zwei unabhängige Befehle: Keiner benötigt ein Ergebnis des anderen. Es gibt im Modell keine Konflikte. Die Tabelle zeigt den Ablauf bei anfangs leerer Pipeline. Ohne Überlappung würden die beiden Befehle zusammen sechs Takte benötigen; mit Überlappung sind es vier. Ein einzelner Befehl durchläuft weiterhin drei Takte. Nach dem Füllen kann bei fortlaufender Arbeit in diesem Modell pro Takt ein weiterer Befehl fertig werden. Diese Zahlen gelten für das beschriebene Modell, nicht für jeden echten Prozessor.
Den erreichbaren Durchsatz begrenzen Pipeline-Konflikte: Zwei Befehle können gleichzeitig dieselbe besetzte Recheneinheit benötigen. Ein Befehl kann auf ein noch nicht verfügbares Ergebnis angewiesen sein. Oder eine Entscheidung darüber, welcher Befehl als Nächstes folgt, steht noch aus. Zur Lösung können betroffene Befehle warten. Mit passender Technik lassen sich fertige Zwischenergebnisse früh weiterreichen. Auch das Umordnen unabhängiger Befehle kann helfen. Deshalb muss ein abhängiger Befehl nicht in jedem Fall bis zum vollständigen Abschluss seines Vorgängers warten; die benötigten Daten müssen aber verfügbar sein.
| Takt | Befehl P | Befehl Q |
|---|---|---|
| 1 | Holen | Noch nicht begonnen |
| 2 | Bearbeiten | Holen |
| 3 | Abschließen | Bearbeiten |
| 4 | Bereits fertig | Abschließen |
Merke: Pipelining nutzt Überlappung für einen höheren möglichen Durchsatz. Das Füllen der Pipeline und mögliche Konflikte begrenzen den Vorteil. Pipelining ist auch bei CISC möglich.
Teste dich
Alles auf einen Blick
RISC
RISC setzt auf einfache, leicht erkennbare Befehle und viele Register.
Bei der erklärten Load/Store-Architektur übertragen Lade- und Speicherbefehle Werte zwischen Datenspeicher und Registern.
Benötigte Speicherwerte werden geladen, sofern sie noch nicht in Registern vorliegen, und dort verarbeitet; zurückgespeichert wird bei Bedarf.
Ein CISC-Befehlssatz kann intern mit einfachen Schritten umgesetzt werden; RISC ist nicht allgemein schneller.
Pipelining kann durch überlappende Verarbeitung mehr Befehle pro Zeit abschließen.
Ein einzelner Befehl wird nicht automatisch schneller; das Füllen der Pipeline und Konflikte begrenzen den Vorteil.
Eine Stückzahl im erfundenen Rechenmodell bestimmen
- 1Gegeben sind erfundene Daten: Im Datenspeicher stehen unter „Beutel“ 6 und unter „Stück je Beutel“ 4. Beide Werte sind noch nicht in Registern.
- 2Gesucht ist die gesamte Stückzahl. Sie soll anschließend unter „Gesamt“ im Datenspeicher stehen.
- 3Lade mit einem Ladebefehl die 6 aus „Beutel“ in R1.
- 4Lade mit einem weiteren Ladebefehl die 4 aus „Stück je Beutel“ in R2.
- 5Multipliziere die Registerwerte und lege das Ergebnis in R3 ab. Es gilt 6\cdot 4=24.
- 6Schreibe mit einem Speicherbefehl die 24 aus R3 nach „Gesamt“. Die Folge besteht aus zwei Ladebefehlen, einem Rechenbefehl und einem Speicherbefehl.
Fehler finden
Fehler in Zeile 3Die dritte Zeile nennt den falschen Ort für die Rechnung. Richtig: Der Rechenbefehl verdoppelt den geladenen Wert direkt im Register. Danach schreibt ein Speicherbefehl das Ergebnis 42 zurück.
Lückentext
Bei der hier erklärten Load/Store-Architektur verarbeitet ein Rechenbefehl die zuvor geladenen Werte in . In der anfangs leeren Modell-Pipeline durchläuft ein einzelner Befehl drei aufeinanderfolgende Stufen von je einem Takt. Bis dieser Befehl fertig ist, braucht er . Die Grundidee, mehrere Arbeitsschritte in einem äußeren Befehl zu bündeln, gehört zu .