

Neuronales Netz: Aufbau, Berechnung und Training
Du unterscheidest Netzschichten, berechnest eine Neuronenausgabe und erklärst Training, wichtige Bauweisen und Hinweise auf Überanpassung.
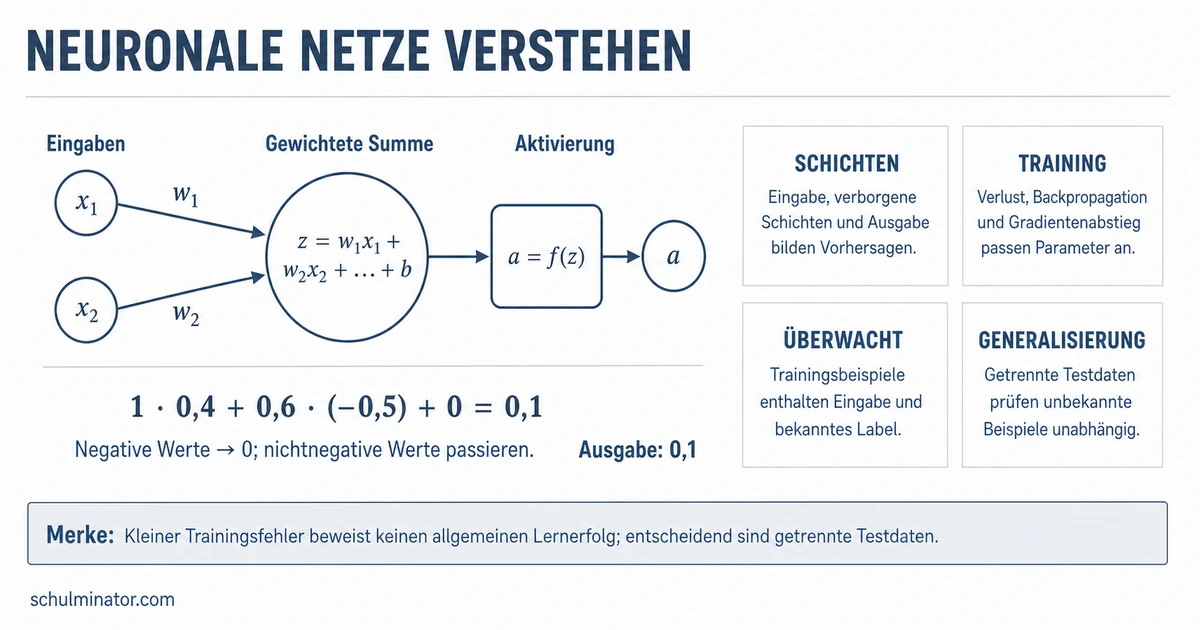
Kurz gesagt
Ein neuronales Netz verarbeitet Eingaben über verbundene Recheneinheiten in Schichten. Verarbeitende Neuronen nutzen Gewichte und Aktivierungsfunktionen. Beim Training werden einstellbare Werte anhand von Beispielen angepasst.
Ein neuronales Netz ist ein Rechenmodell aus verbundenen Recheneinheiten, den Neuronen. Es kann anhand von Beispielen lernen, Zahlen vorherzusagen oder Eingaben Gruppen zuzuordnen. Dafür brauchst du drei Grundideen: den Aufbau in Schichten, die Rechnung eines Neurons und das wiederholte Anpassen seiner einstellbaren Werte.
Deine Lernziele
Eine Schicht fasst Recheneinheiten mit einer gemeinsamen Rolle zusammen. Die Eingabeschicht nimmt die vorbereiteten Zahlenwerte entgegen. Das können etwa Helligkeitswerte eines Bildes oder gemessene Längen sein. Solche Eigenschaften einer Eingabe heißen Merkmale.
Zwischen Eingabe und Ausgabe liegen bei einem tiefen neuronalen Netz mehrere verborgene Schichten. Auch ein Netz mit einer einzigen verborgenen Schicht ist möglich. Diese Schichten verrechnen die übernommenen Werte und bilden daraus neue Merkmale. „Verborgen“ beschreibt ihre Lage innerhalb des Netzes: Sie sind weder die Eingabe noch das Endergebnis.
Die Ausgabeschicht liefert das Ergebnis des Netzes. Das kann ein vorhergesagter Zahlenwert oder die Zuordnung zu einer Gruppe sein. Eine solche Vorhersage kann falsch sein. Die Rolle einer Schicht hängt von ihrer Stelle und Aufgabe im Netz ab, nicht davon, wie groß ihre Zahlenwerte sind.
Neuronales Netz
Ein Rechenmodell aus verbundenen Recheneinheiten. Seine einstellbaren Werte bestimmen, wie es Eingaben verarbeitet.
| Schicht | Aufgabe |
|---|---|
| Eingabeschicht | Nimmt die vorbereiteten Eingabewerte entgegen. |
| Verborgene Schicht | Verarbeitet Werte innerhalb des Netzes zu neuen Merkmalen. |
| Ausgabeschicht | Liefert das Endergebnis des Netzes. |
Beispiel: Formen zuordnen: ein ausgedachtes Netz
- 1Die Eingabeschicht erhält Zahlenwerte für Breite und Höhe einer gezeichneten Form.
- 2Eine verborgene Schicht verrechnet diese Werte zu neuen Merkmalen.
- 3Die Ausgabeschicht liefert die vorhergesagte Gruppe, etwa „schmal“ oder „breit“.
Teste dich
Ein Neuron multipliziert jede Eingabe mit einem zugehörigen Gewicht. Das Gewicht bestimmt den Beitrag dieser Eingabe zur Rechnung. Ein negatives Gewicht kann dabei einen negativen Beitrag erzeugen. Anschließend addiert das Neuron die Produkte. Ein zusätzlicher einstellbarer Wert heißt Bias. Er wird ebenfalls addiert und verschiebt den Zwischenwert.
Für zwei Eingaben nennen wir die Eingabewerte x_1 und x_2, die zugehörigen Gewichte w_1 und w_2 und den Bias b. Die kleinen Zahlen kennzeichnen die erste und zweite Eingabe. Der Punkt \cdot bedeutet Multiplikation. Der Zwischenwert z ist die gewichtete Summe einschließlich Bias: z = w_1 \cdot x_1 + w_2 \cdot x_2 + b. Bei einer Eingabe lautet die Rechnung entsprechend z = w \cdot x + b.
Danach bestimmt eine Aktivierungsfunktion aus dem Zwischenwert die Ausgabe. Eine häufige Aktivierungsfunktion heißt ReLU. Das ist die Abkürzung für englisch „Rectified Linear Unit“, etwa „gleichgerichtete lineare Einheit“. Wir nennen ihre Ausgabe a. Für z < 0 gilt a = 0. Für z \geq 0 gilt a = z; das Zeichen \geq bedeutet „größer oder gleich“. ReLU lässt also positive Werte und null unverändert. Negative Werte werden zu null. Andere Aktivierungsfunktionen haben andere Rechenregeln.
Aktivierungsfunktion
Eine Rechenregel, die aus dem Zwischenwert eines Neurons dessen Ausgabe bestimmt. ReLU setzt negative Zwischenwerte auf null.
Beispiel: Zwei Eingaben verrechnen: ausgedachte Werte
- 1Gegeben sind x_1 = 2, x_2 = 5, w_1 = 3, w_2 = -2 und b = 1.
- 2Die gewichteten Beiträge sind 3 \cdot 2 = 6 und (-2) \cdot 5 = -10.
- 3Mit Bias ergibt sich z = 6 - 10 + 1 = -3.
- 4ReLU setzt den negativen Zwischenwert auf null: a = 0.
Merke: Rechne in dieser Reihenfolge: Eingaben gewichten, Produkte und Bias addieren, Aktivierungsfunktion anwenden. Zwischenwert und Ausgabe können verschieden sein.
Teste dich
Beim hier beschriebenen Training verarbeitet das Netz Beispiele, deren gewünschte Ausgaben als Zielwerte bekannt sind. Gewichte und Bias-Werte sind seine einstellbaren Parameter. Ein Trainingsschritt beginnt mit einem Vorwärtsdurchlauf: Die Eingaben werden mit den aktuellen Parametern bis zur Ausgabe verarbeitet. So entsteht eine Vorhersage.
Eine Verlustfunktion vergleicht die Vorhersage mit dem bekannten Zielwert. Ihr Ergebnis heißt Verlust. Er misst die Abweichung nach einer festgelegten Regel. Für diese Regel bedeutet ein kleinerer Verlust eine geringere Abweichung. Eine mögliche Regel für einen vorhergesagten Zahlenwert ist das Quadrat der Differenz zum Zielwert.
Danach folgt Backpropagation, auf Deutsch etwa „Rückwärtsweitergabe“. Dieses Rechenverfahren verfolgt die Abhängigkeiten vom Verlust rückwärts durch das Netz. Es berechnet Ableitungen des Verlusts nach den Parametern. Eine Ableitung beschreibt hier Richtung und Stärke der lokalen Änderung des Verlusts, wenn ein Parameter ein kleines Stück verändert wird. Die zusammengefassten Ableitungen bilden den Gradienten. Backpropagation berechnet diese Werte; sie ist vom anschließenden Ändern der Parameter zu unterscheiden.
Ein Optimierer ist das Verfahren, das die Parameter mithilfe dieser Werte anpasst. Beim Gradientenabstieg wird von jedem Parameter das Produkt aus Lernrate und zugehörigem Gradientenwert abgezogen. Die Lernrate ist ein positiver Faktor für die Schrittweite. Ein positiver Gradientenwert verkleinert beim Schritt den Parameter, ein negativer vergrößert ihn. Die Richtung soll den Verlust verringern; ein einzelner Schritt garantiert das nicht. Danach beginnt der Ablauf mit weiteren Trainingsbeispielen erneut. Wiederholung allein garantiert ebenfalls keine guten Vorhersagen.
Beispiel: Einen Verlust bestimmen: ausgedachte Werte
- 1Ein Netz sagt für ein Beispiel den Zahlenwert vier voraus. Der bekannte Zielwert ist sieben.
- 2Als Verlustfunktion wählen wir das Quadrat der Differenz: (4 - 7)^2 = 9.
- 3Der Verlust beträgt neun. Daraus ist noch nicht ablesbar, welches einzelne Gewicht wie stark geändert werden sollte.
- 4Dafür berechnet Backpropagation die Ableitungen. Anschließend passt der Optimierer die Parameter an.
Merke: Der Trainingszyklus lautet: Vorhersage berechnen, Verlust bestimmen, Ableitungen mit Backpropagation berechnen, Parameter mit dem Optimierer anpassen.
Teste dich
Die Architektur eines Netzes ist seine Bauweise. Ein Convolutional Neural Network, kurz CNN, heißt auf Deutsch etwa „faltendes neuronales Netz“. Es nutzt Filter: Rechenregeln, die benachbarte Eingabewerte gemeinsam verarbeiten. Derselbe Filter wird an verschiedenen Stellen angewendet. So lassen sich räumliche Merkmale wie kleine Bildmuster berechnen. CNN werden deshalb häufig für Bilder eingesetzt.
Ein Recurrent Neural Network, kurz RNN, ist ein rekurrentes, also rückgekoppeltes neuronales Netz. Es verarbeitet eine Sequenz: eine geordnete Folge, bei der die Reihenfolge eine Rolle spielt. Bei jedem Schritt kann ein gespeicherter Zustand aus früheren Schritten einfließen. Dieser Zustand wird weitergeführt und kann Informationen über frühere Eingaben enthalten. RNN sind damit für Folgen wie aufeinanderfolgende Messwerte oder Wörter gebaut. CNN und RNN haben typische Einsatzbereiche; diese sind nicht ausschließlich.
Überanpassung bedeutet: Das Netz passt sich stark an Besonderheiten der Trainingsbeispiele an und sagt bei neuen, passenden Beispielen schlechter voraus. Zum Erkennen nutzt du Validierungsdaten. Das sind beiseitegelegte Beispiele mit bekannten Zielwerten. Sie helfen während der Entwicklung, Trainingsstände zu vergleichen. Im beschriebenen Ablauf werden die Gewichte nicht durch Trainingsschritte mit diesen Daten angepasst. Der Validierungsverlust misst die Abweichung der Vorhersagen von den Zielwerten dieser Daten. Ein kleinerer Verlust bedeutet bei derselben Verlustfunktion eine geringere Abweichung.
Wenn der Trainingsverlust weiter sinkt, während der Validierungsverlust steigt, ist das bei vergleichbaren Datensätzen ein Hinweis auf Überanpassung. Der Verlauf allein ist kein Beweis. Prüfe auch, ob beide Datensätze dieselbe Aufgabe abbilden und hinsichtlich Eingaben und Zielwerten vergleichbar sind. Ein separater Testdatensatz dient erst der abschließenden Bewertung des gewählten Modells. Er übernimmt damit eine andere Rolle als die Validierungsdaten.
| Bauweise | Kennzeichen | Typischer Einsatz |
|---|---|---|
| CNN | Gleiche Filter verarbeiten benachbarte Werte an verschiedenen Stellen. | Räumliche Muster in Bildern |
| RNN | Ein Zustand aus früheren Schritten fließt in folgende Schritte ein. | Geordnete Folgen von Wörtern oder Messwerten |
Beispiel: Zwei Trainingsstände vergleichen: ausgedachte Werte
- 1Beide Datensätze enthalten vergleichbar zusammengestellte Bilder derselben Aufgabe. Für beide wird dieselbe Verlustfunktion verwendet.
- 2Nach einem frühen Trainingsabschnitt: Trainingsverlust 0,7; Validierungsverlust 0,8.
- 3Nach einem späteren Trainingsabschnitt: Trainingsverlust 0,3; Validierungsverlust 1,0.
- 4Der Trainingsverlust sinkt, während der Validierungsverlust steigt. Das spricht hier für Überanpassung, beweist sie aber nicht.
Merke: Trainingsdaten dienen dem Anpassen der Parameter. Validierungsdaten helfen beim Vergleichen während der Entwicklung. Separate Testdaten dienen der abschließenden Bewertung.
Teste dich
Alles auf einen Blick
Neuronales Netz
Die Eingabeschicht nimmt Werte auf, verborgene Schichten verarbeiten sie, die Ausgabeschicht liefert das Ergebnis.
Eingaben werden gewichtet und mit dem Bias addiert. Danach bestimmt die Aktivierungsfunktion die Ausgabe.
Backpropagation berechnet Ableitungen des Verlusts; der Optimierer passt anschließend die Parameter an.
CNN sind typisch für räumliche Muster, RNN für geordnete Folgen. Ihre Einsatzbereiche sind nicht ausschließlich.
Sinkender Trainingsverlust bei steigendem Validierungsverlust ist bei vergleichbaren Datensätzen ein Hinweis, kein Beweis.
Zwei Bias-Einstellungen vergleichen: ausgedachtes Beispiel
- 1Ein ReLU-Neuron hat die Eingabe x = 6 und das Gewicht w = -0{,}5. Vergleiche die Ausgaben für den Bias zwei und den Bias vier.
- 2Der gewichtete Beitrag ist in beiden Fällen w \cdot x = (-0{,}5) \cdot 6 = -3.
- 3Mit b = 2 entsteht der Zwischenwert z = -3 + 2 = -1.
- 4ReLU setzt diesen negativen Zwischenwert auf null: a = 0.
- 5Mit b = 4 entsteht dagegen z = -3 + 4 = 1. ReLU lässt diesen Wert unverändert: a = 1.
- 6Bei einem Bias von vier ist die Ausgabe größer: eins statt null.
Fehler finden
Fehler in Zeile 3Die dritte Zeile übernimmt den negativen Zwischenwert unverändert. ReLU setzt ihn auf null. Richtig: Die ReLU-Ausgabe beträgt a = 0.
Lückentext
Die Schicht, die vorbereitete Zahlenwerte zuerst entgegennimmt, heißt . Die Ableitungen des Verlusts nach den Parametern werden bei der bestimmt. ReLU gibt bei einem negativen Zwischenwert aus.