

Überanpassung im Machine Learning erkennen
Du erkennst Überanpassung, trennst Daten zum Lernen und Prüfen und erklärst, warum passende Modellgrenzen helfen.
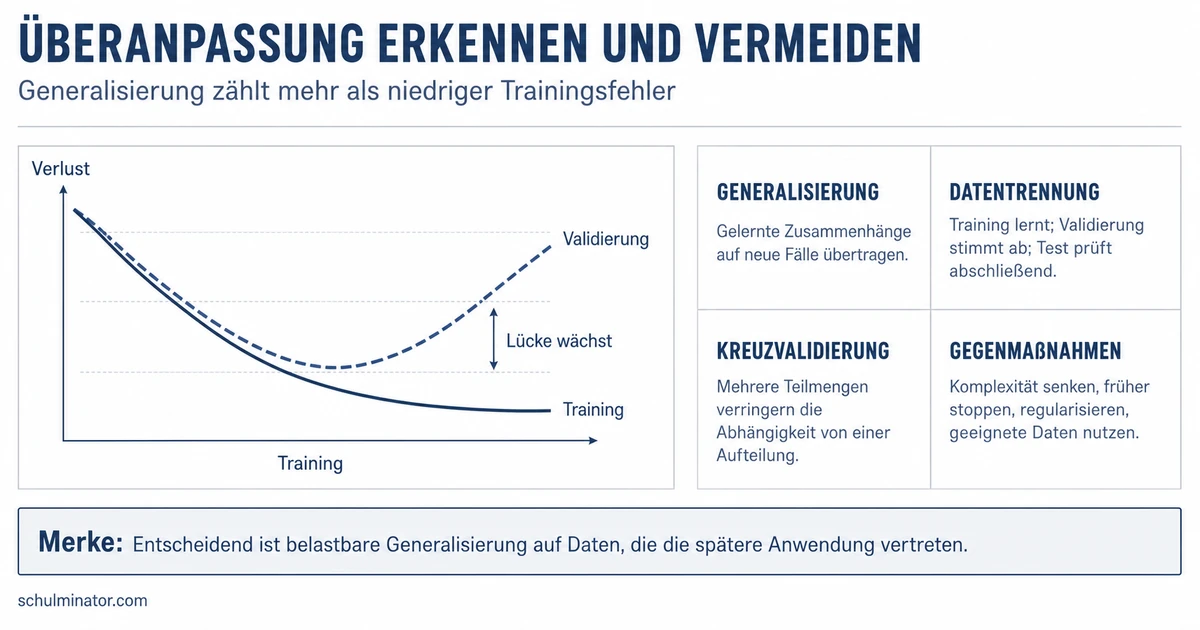
Kurz gesagt
Sinkt der Fehler beim Lernen, während er bei getrennten Prüfdaten steigt, deutet das auf Überanpassung hin. Für die laufende Auswahl dienen Auswahldaten, die Validierungsdaten. Testdaten bleiben für die abschließende Bewertung zurück.
Ein Modell ist hier eine Rechenvorschrift, die aus Eingaben eine Vorhersage bildet. Beim maschinellen Lernen wird sie anhand von Beispielen angepasst; diese Beispiele heißen Trainingsdaten. Ziel sind brauchbare Vorhersagen für neue, passende Fälle. Ein kleiner Fehler bei den Trainingsdaten reicht dafür nicht aus.
Deine Lernziele
Ein Fehlermaß beschreibt, wie stark die Vorhersagen von den richtigen Antworten abweichen. Bei einer Sortieraufgabe kannst du beispielsweise die falsch zugeordneten Fälle zählen. Der Trainingsfehler wird an den Beispielen gemessen, mit denen das Modell gelernt hat. Der Testfehler wird an getrennten, beim Lernen und Auswählen ungenutzten Beispielen gemessen.
Die Flexibilität eines Modells beschreibt, wie unterschiedliche Zusammenhänge es darstellen kann. Ein sehr flexibles Modell kann neben brauchbaren Mustern auch zufällige Besonderheiten der Trainingsdaten übernehmen. Dadurch kann sein Trainingsfehler sinken, während sein Testfehler steigt. Das ist ein Hinweis auf Überanpassung. Aus diesem Verlauf folgt aber noch nicht, dass die Testdaten den geplanten Einsatz passend vertreten.
Bei Unteranpassung ist die Modellform für den vorhandenen Zusammenhang zu eingeschränkt. Dann bleiben häufig sowohl Trainingsfehler als auch Testfehler hoch. Beispielsweise kann eine Gerade eine benötigte Krümmung nicht darstellen. Zwei hohe Fehlerwerte allein beweisen Unteranpassung jedoch nicht; auch ungeeignete Daten können Probleme verursachen.
Schematisch kann der Testfehler mit wachsender Flexibilität zunächst sinken und später wieder steigen. Dieser Verlauf ist keine feste Regel für jedes Modell. Während des Lernens beobachtest du für Auswahlentscheidungen den Fehler auf getrennten Auswahldaten, den Validierungsdaten. Der Test bleibt für die abschließende Bewertung zurück.
Überanpassung
Ein Modell übernimmt Besonderheiten seiner Trainingsbeispiele so stark, dass es auf neuen, passenden Beispielen schlechter abschneidet. Ein sehr kleiner Trainingsfehler allein belegt deshalb keine gute Leistung bei neuen Fällen.
| Modell | Trainingsfehler | Testfehler |
|---|---|---|
| Mäßig flexibler Blattsortierer | 8 falsche von 100 Fällen | 10 falsche von 100 Fällen |
| Sehr flexibler Blattsortierer | 2 falsche von 100 Fällen | 17 falsche von 100 Fällen |
Merke: Die Tabelle zeigt erfundene Ergebnisse zweier vorab festgelegter Modelle zur Unterscheidung von Blattsorten. Der sinkende Trainingsfehler bei steigendem Testfehler veranschaulicht Überanpassung. Eine Modellwahl anhand dieser Testwerte würde den Test zur Auswahl verwenden.
Teste dich
Die drei Datenmengen haben verschiedene Aufgaben. Mit Trainingsdaten wird die Rechenvorschrift angepasst. Mit Validierungsdaten vergleichst du Modelle und wählst Einstellungen oder einen geeigneten Zeitpunkt zum Beenden des Lernens. Mit Testdaten bewertest du das ausgewählte Modell abschließend.
Die Mengen müssen getrennt sein: Ein Beispiel gehört nicht zugleich zum Training und zur Validierung oder zum Test. Auch Kopien eines Trainingsbeispiels sind keine neuen Prüffälle. Andernfalls kann ein guter Prüfwert teilweise darauf beruhen, dass das Modell die Beispiele bereits kennt.
Auch die Validierungsdaten beeinflussen das Ergebnis: Du wählst anhand ihrer Ergebnisse aus. Bei vielen Entscheidungen kann die Auswahl zunehmend an Besonderheiten dieser Daten angepasst werden. Deshalb brauchst du daneben einen Test, der von der Auswahl unbeeinflusst bleibt.
Wenn du nach jedem Testwert das Modell änderst, verwendest du den Test ebenfalls zur Auswahl. Den besten bisherigen Testwert kannst du dann nicht als unbeeinflusste Abschlussbewertung behandeln. Für einen neuen Abschlusstest brauchst du frische, passende und bisher ungenutzte Beispiele. Auch häufig verwendete Validierungsdaten können durch frische Beispiele ergänzt oder ersetzt werden.
Prüfmengen müssen außerdem ausreichend viele passende Fälle enthalten. Bei sehr wenigen Fällen kann schon ein einzelner Zufallstreffer das Ergebnis stark verändern. Eine feste Anzahl, die für jede Aufgabe genügt, gibt es nicht.
Beispiel: Ein erfundener Sortierer für Becher- und Tellerfotos
- 1Der Entwickler passt das Modell mit den Trainingsfotos und ihren richtigen Zuordnungen an.
- 2Er vergleicht mehrere Lernstände anhand anderer Fotos: der Validierungsdaten.
- 3Er wählt den Lernstand mit dem günstigsten Validierungsergebnis nach seiner vorher festgelegten Regel.
- 4Er bewertet diesen Stand abschließend mit bisher ungenutzten Testfotos. Kein Foto kommt in mehreren Mengen vor.
Teste dich
Parameter sind einstellbare Zahlen einer Rechenvorschrift. Beim Lernen werden ihre Werte angepasst. Ein Modell kann viele unterschiedliche Zusammenhänge darstellen, wenn seine Form und seine einstellbaren Werte das erlauben. Begrenzungen können verhindern, dass es zufälligen Besonderheiten zu genau folgt.
Early Stopping bedeutet frühzeitiges Beenden des Lernens. Ein Lernschritt ist hier ein weiterer Anpassungsschritt des Modells. Du beobachtest den Validierungsfehler und beendest das Lernen nach einer vorher festgelegten Regel, wenn dieser Fehler wieder ansteigt. Aus den gespeicherten Lernständen wählst du nach dem Validierungsfehler aus. Der Trainingsfehler kann beim früheren Stand höher sein, während der spätere Testfehler niedriger ausfallen kann. Testdaten steuern diese Auswahl nicht.
Early Stopping ist eine schnelle, aber selten optimale Form der Regularisierung. Regularisierung bedeutet, das Lernen so zu begrenzen, dass übermäßige Anpassung erschwert wird. Eine weitere Form ergänzt das Lernziel um zusätzliche Kosten, einen Strafterm, für übermäßige Modellkomplexität. Modellkomplexität meint hier, wie aufwendig und flexibel die darstellbaren Zusammenhänge sind. Eine sorgfältig gewählte Stärke dieser Begrenzung kann bessere Ergebnisse liefern als Early Stopping; daraus folgt keine garantierte Rangfolge für jeden Einzelfall.
Weniger frei einstellbare Parameter können innerhalb einer festgelegten Modellfamilie die Auswahl möglicher Formen einschränken. Das kann Überanpassung verringern. Wird dabei eine benötigte Form ausgeschlossen, entsteht jedoch Unteranpassung. Allein aus der Parameterzahl lässt sich deshalb keine allgemeine Rangfolge verschiedener Modellarten ableiten.
Das Verzerrung-Varianz-Dilemma beschreibt diesen möglichen Konflikt. Verzerrung meint hier systematische Abweichungen, etwa durch eine zu enge Modellform. Varianz beschreibt, wie stark sich das gelernte Modell bei anderen zufällig gezogenen Trainingsbeispielen derselben Herkunft ändern würde. Ein sehr eingeschränktes Modell hat im schematischen Vergleich eher hohe Verzerrung und geringe Varianz; ein sehr flexibles eher geringe Verzerrung und hohe Varianz. Eine stärkere Begrenzung kann also Zufallseinflüsse verringern und zugleich wichtige Muster ausschließen. Die passende Stärke wählst du mit Validierungsdaten.
Beispiel: Eine Modellform gezielt einschränken
- 1Betrachte die Rechenvorschrift y=ax^2+bx+c. Dabei ist x die Eingabezahl und y die Vorhersagezahl; beide haben hier keine Einheit. x^2 ist das Quadrat von x.
- 2Die Zahlen a, b und c sind drei frei einstellbare Parameter.
- 3Legst du a=0 fest, bleibt y=bx+c. Jetzt sind zwei Parameter frei einstellbar, und die möglichen Formen sind Geraden.
- 4Diese Einschränkung kann zufällige Krümmungen ausschließen. Braucht die Aufgabe aber eine echte Krümmung, ist die eingeschränkte Form zu einfach.
Merke: Stärker begrenzen heißt nicht automatisch besser vorhersagen. Begrenzungen sollen zufällige Besonderheiten zurückdrängen, ohne die benötigten Muster auszuschließen.
Teste dich
Die Verteilung von Daten beschreibt hier, welche Arten von Fällen unter welchen Bedingungen vorkommen und wie häufig sie sind. Dazu gehören auch die Zusammenhänge zwischen Eingaben und richtigen Antworten. Eine Datenmenge ist repräsentativ, wenn sie die für die Aufgabe wichtigen Eigenschaften der vorgesehenen Fälle angemessen vertritt.
Trainings- und Testdaten sollen dieselbe für den Einsatz wichtige Verteilung repräsentieren. Das bedeutet weder identische Beispiele noch exakt gleiche beobachtete Häufigkeiten. Getrennte, zufällig gezogene Mengen können etwas unterschiedliche Anteile enthalten und trotzdem dieselbe Herkunft angemessen vertreten. Wichtige Fallarten dürfen aber nicht systematisch fehlen. Das gilt auch für Validierungsdaten.
Die Übereinstimmung von Training und Test reicht nicht aus: Beide müssen zu den vorgesehenen neuen Daten passen. Enthalten beide beispielsweise ausschließlich Sommerfälle, lässt ein guter Testwert die Leistung bei andersartigen Winterfällen offen. Der gute Wert belegt dann auch keine zu einfache Modellform; dafür müsstest du den Zusammenhang zwischen Modellform und Aufgabe untersuchen.
Auch passende Daten bilden die Wirklichkeit nur zu einem bestimmten Zeitpunkt ab. Bedingungen oder Zusammenhänge können sich ändern. Dann können neue Daten, erneutes Lernen und ein neuer Test nötig werden. Ein guter Wert auf ausreichend vielen, ungenutzten und repräsentativen Testfällen ist ein Hinweis auf Generalisierung. Generalisierung bedeutet brauchbare Vorhersagen für neue Fälle der vertretenen Art. Sie ist keine Garantie für jede zukünftige Beobachtung.
Dieselbe Verteilung repräsentieren
Getrennte Datenmengen vertreten dieselben für den Einsatz wichtigen Fallarten, Bedingungen und Zusammenhänge angemessen. Ihre Beispiele müssen dafür verschieden sein; ihre beobachteten Anteile müssen nicht exakt übereinstimmen.
Merke: Frage bei einem guten Testwert auch: Welche neuen Fälle vertritt dieser Test? Ein passender Test für den bisherigen Einsatz kann für veränderte Bedingungen unzureichend sein.
Teste dich
Alles auf einen Blick
Überanpassung
Sinkender Trainingsfehler bei steigendem Fehler auf getrennten Prüfdaten ist ein Hinweis auf Überanpassung.
Lernen nutzt Trainingsdaten, Auswahl nutzt Validierungsdaten und die Abschlussbewertung nutzt ungenutzte Testdaten.
Early Stopping, zusätzliche Kosten für Komplexität und weniger freie Parameter können Überanpassung verringern.
Zu starke Begrenzungen können wichtige Muster ausschließen und Unteranpassung verursachen.
Ein guter Testwert ist für neue Fälle aussagekräftig, wenn der Test deren wichtige Bedingungen angemessen vertritt; eine Garantie ist er nicht.
Einen Lernstand für einen erfundenen Obstfoto-Sortierer auswählen
- 1Aufgabe: Wähle einen gespeicherten Lernstand für die Unterscheidung von reifem und unreifem Obst. Die festgelegte Auswahlregel verlangt den kleinsten Validierungsfehler.
- 2Alle folgenden Fehlerzahlen zählen falsche Zuordnungen bei jeweils 100 Trainingsfällen beziehungsweise 100 getrennten Validierungsfällen. Die Zahlen sind erfunden.
- 3Nach 4 Lernschritten: Trainingsfehler 18 falsche Fälle, Validierungsfehler 16 falsche Fälle.
- 4Nach 8 Lernschritten: Trainingsfehler 9 falsche Fälle, Validierungsfehler 11 falsche Fälle.
- 5Nach 12 Lernschritten: Trainingsfehler 5 falsche Fälle, Validierungsfehler 14 falsche Fälle.
- 6Wähle den gespeicherten Stand nach 8 Lernschritten: 11 ist der kleinste der drei Validierungsfehler. Der spätere Stand lernt die Trainingsfälle besser, schneidet bei der Validierung aber schlechter ab.
- 7Bewerte den ausgewählten Stand anschließend mit bisher ungenutzten, passenden Testdaten. Die Validierungsauswahl garantiert noch keinen bestimmten Testwert.
Fehler finden
Fehler in Zeile 2Die zweite Aussage setzt Erfolg bei bekannten Beispielen mit Erfolg bei neuen Fällen gleich. Richtig: Ein kleiner Trainingsfehler genügt nicht als Beleg für gute Vorhersagen bei neuen Fällen.
Lückentext
Ein Modell soll einen gekrümmten Zusammenhang darstellen, seine Form ist aber auf Geraden beschränkt. Das daraus entstehende Problem heißt . Die getrennten Daten, anhand deren du zwischen gespeicherten Lernständen auswählst, heißen . Ein Test enthält ausschließlich rote Spielsteine; im vorgesehenen Einsatz kommen rote und blaue vor. Damit sind die vorgesehenen Farben im Test vertreten.