

Überwachtes Lernen einfach erklärt
Du lernst, wie Modelle aus gelabelten Daten lernen, welche Daten sie zum Prüfen brauchen und wie du eine eigene Lernaufgabe planst.
Kurz gesagt
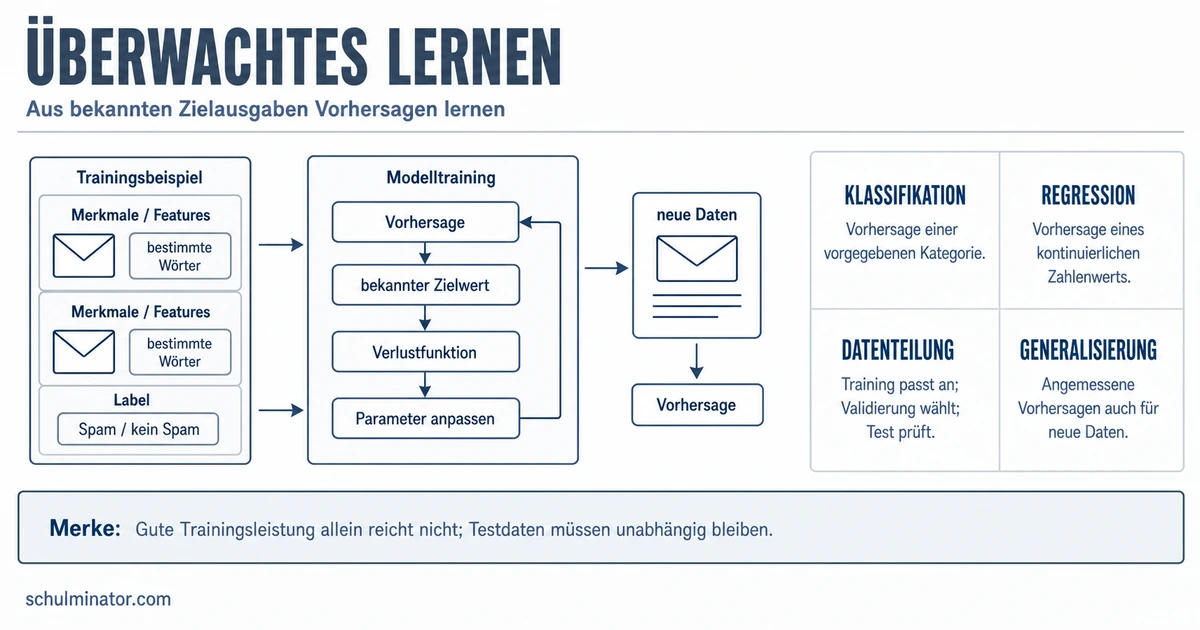
Beim überwachten Lernen lernt ein Modell aus Beispielen mit bekannten Zielwerten, den Labels. Es soll daraus Kategorien oder Messwerte für neue Beispiele vorhersagen; getrennte Daten helfen, diese Leistung zu prüfen.
Ein Modell ist hier ein mathematisches Verfahren, das aus Eingaben eine Vorhersage berechnet. Beim überwachten Lernen erhält es zum Lernen Beispiele mit bekannten Antworten. Du lernst, wie du solche Beispiele auswählst und Vorhersagen auf neuen Daten prüfst. Alle folgenden Fälle sind erfunden.
Deine Lernziele
Ein Beispiel besteht aus Merkmalen und einem Label. Merkmale sind die Eingabewerte, aus denen das Modell seine Vorhersage berechnet. Das Label ist der bekannte Zielwert, den es vorhersagen soll. Ein Beispiel mit Merkmalen und bekanntem Label heißt gelabelt.
Beim Training, also beim Lernen, vergleicht das Verfahren seine Vorhersagen mit den bekannten Labels. Die Abweichungen helfen ihm, den Zusammenhang zwischen Merkmalen und Zielwerten anzupassen. Viele Lernverfahren wiederholen solche Anpassungen schrittweise. Bei einer späteren Vorhersage erhält das Modell die Merkmale; das gesuchte Label ist dabei noch unbekannt.
Bei der Klassifikation ist das Ziel eine Kategorie, also eine vorgegebene Gruppe. Bei der Regression ist das Ziel eine zahlenmäßig bestimmte Größe, etwa eine Dauer oder Masse. Entscheidend ist die Bedeutung des Labels. Eine Kategorie bleibt eine Kategorie, wenn du sie als Zahlencode speicherst. Auch messbare Eingaben machen eine Aufgabe nicht zur Regression: Der Aufgabentyp richtet sich nach dem Ziel.
Gelabelte Daten
Gelabelte Daten enthalten Beispiele mit Eingabemerkmalen und den dazu bekannten Zielwerten. Diese Zielwerte heißen Labels.
Beispiel: Zwei Vorhersageziele für Obst
- 1Als Merkmale sollen Höhe und Breite einer Frucht dienen.
- 2Soll das Modell „Apfel“ oder „Birne“ vorhersagen, ist das eine Klassifikation.
- 3Soll es die Masse der Frucht in Gramm vorhersagen, ist das eine Regression.
- 4Ob die gewählten Merkmale ausreichend gute Vorhersagen erlauben, muss anschließend geprüft werden.
Teste dich
Holdout bedeutet hier Zurückhalten: Du teilst die gelabelten Beispiele vor dem Lernen in getrennte Datenteile auf. Im hier beschriebenen Vorgehen gibt es Trainingsdaten, Validierungsdaten und Testdaten. Kein Beispiel darf in mehreren Teilen vorkommen.
Mit den Trainingsdaten lernt das Modell. Mit den Validierungsdaten vergleichst du nach dem Training verschiedene Einstellungen und wählst eine davon aus. Einstellungen sind Vorgaben dafür, wie das Lernen abläuft. Die Testdaten bleiben bis zur abschließenden Bewertung ungenutzt. Beim Bewerten erhält das Modell die Merkmale. Seine Vorhersagen vergleichst du anschließend mit den zurückgehaltenen Labels.
Wenn du nach Testresultaten Einstellungen auswählst, beeinflussen die Testdaten deine Auswahl. Der anschließende Testwert ist dann keine unabhängige Abschlussbewertung mehr. Verborgene Labels während der Vorhersage und getrennte Trainingsbeispiele verhindern dieses Problem nicht. Auch häufige Entscheidungen anhand derselben Validierungsdaten können die Auswahl zu stark auf diese Daten ausrichten. Für eine neue unabhängige Bewertung können deshalb frische Prüfdaten nötig sein.
Validierungs- und Testdaten müssen ausreichend viele Beispiele enthalten und zur vorgesehenen Anwendung passen. Sie sollen die wichtigen Bedingungen der Trainingsdaten und der späteren Anwendung abdecken. Ein kleiner, einseitiger Datenteil liefert unsichere Ergebnisse. Eine feste Dreiteilung lässt weniger Daten zum Lernen übrig; das Ergebnis kann zudem von der gewählten Aufteilung abhängen.
| Datenteil | Aufgabe | Nutzung |
|---|---|---|
| Trainingsdaten | Zusammenhänge aus Merkmalen und Labels lernen | Beim Anpassen des Modells |
| Validierungsdaten | Einstellungen vergleichen und auswählen | Während der Entwicklung |
| Testdaten | Das ausgewählte Modell abschließend bewerten | Nach Abschluss der Auswahl |
Teste dich
Generalisierung bedeutet Verallgemeinerung: Ein Modell soll passende Vorhersagen für bisher ungesehene Beispiele liefern. Gemeint sind neue Daten aus der vorgesehenen Anwendung. Eine gute Leistung auf bekannten Trainingsbeispielen reicht dafür nicht aus.
Überanpassung, auch Overfitting genannt, entsteht, wenn ein Modell Besonderheiten der Trainingsdaten zu stark übernimmt und dadurch schlechter auf neue, passende Daten überträgt. Ein Modell könnte etwa bekannte Labels wiedergeben, ohne brauchbare Zusammenhänge für neue Beispiele zu lernen. Mehr Lernschritte mit denselben Trainingsdaten belegen deshalb keine bessere Verallgemeinerung.
Sehr gute Trainingsleistung bei deutlich schlechterer Leistung auf unabhängigen, passenden Prüfdaten ist ein Warnsignal für Überanpassung. Unabhängig bedeutet hier: Die Prüfdaten wurden weder zum Lernen noch zur Auswahl von Einstellungen verwendet. Gute Vorhersagen auf solchen Daten liefern Hinweise auf Verallgemeinerung, aber keine Garantie für jede spätere Situation.
Der Leistungsabstand allein beweist keine Überanpassung. Prüfe auch die Zusammensetzung und den Umfang der Prüfdaten. Schlechte Ergebnisse können zum Beispiel mit Bedingungen zusammenhängen, die von der vorgesehenen Anwendung abweichen. Soll ein Modell Bilder bei Tageslicht verarbeiten, beurteilen dunkle Nachtbilder dieses Ziel nicht passend.
Merke: Sehr gute Trainingsleistung bei deutlich schlechterer Leistung auf unabhängigen, passenden Prüfdaten ist ein Warnsignal für Überanpassung, kein Beweis. Prüfe auch Umfang und Zusammensetzung der Prüfdaten.
Teste dich
Bestimme zuerst das Vorhersageziel: Was soll das Modell für ein neues Beispiel ausgeben? Lege dann Merkmale fest, die zum Zeitpunkt der Vorhersage verfügbar sind. Sammle passende Beispiele mit zuverlässig bekannten Labels. Das gesuchte Label darf bei der späteren Vorhersage nicht als Eingabemerkmal vorausgesetzt werden.
Entscheide anhand des Labels zwischen Klassifikation und Regression. Plane dann die Trennung in Trainings-, Validierungs- und Testdaten. Alle Teile müssen zum Ziel passen und genügend Beispiele enthalten. Zufälliges Verteilen eignet sich nicht pauschal für jede Sammlung: Zusammengehörige Beispiele können Informationen zwischen den Teilen übertragen. Wenn du neue Gegenstände prüfen willst, bleiben mehrere Fotos desselben Gegenstands deshalb zusammen in einem Datenteil. Wähle Testbilder auch nicht nach einer besonderen Bildqualität aus, wenn die Anwendung unterschiedliche Bildqualitäten umfasst.
Bei Vorhersagen für spätere Zeitpunkte muss die Trennung die zeitliche Reihenfolge berücksichtigen. Ein möglicher Plan nutzt frühere Beispiele zum Lernen, danach liegende zur Auswahl und noch spätere zum abschließenden Test. Zukünftige Informationen dürfen dabei nicht in das Lernen einfließen.
Trainiere mit den Trainingsdaten und wähle Einstellungen anhand der Validierungsdaten. Prüfe das ausgewählte Modell zum Schluss mit den Testdaten: Gib ihm deren Merkmale und vergleiche die Vorhersagen mit den bekannten Labels. Bei Kategorien kannst du richtige und falsche Zuordnungen zählen. Bei Messgrößen kannst du die Abstände zwischen Vorhersagen und bekannten Werten betrachten. Beide Auswertungen beschreiben die geprüften Daten; sie garantieren keine fehlerfreien späteren Vorhersagen.
Beispiel: Ein Plan für Stoffreste
- 1Ziel ist die Vorhersage der Materialkategorie „Baumwolle“ oder „Wolle“. Das ist eine Klassifikation.
- 2Als mögliche Merkmale erfassen wir Dicke und Masse gleich großer Stoffstücke. Die bekannten Materialangaben liefern die Labels.
- 3Mehrere Aufnahmen desselben Stoffstücks bleiben im selben Datenteil, weil später neue Stücke erkannt werden sollen.
- 4Wir lernen mit Trainingsdaten, wählen Einstellungen mit Validierungsdaten und zählen zum Abschluss richtige und falsche Zuordnungen auf Testdaten.
- 5Ob diese Merkmale für die Aufgabe ausreichen, beurteilen wir anhand der unabhängigen Testergebnisse.
Teste dich
Alles auf einen Blick
Überwachtes Lernen
Bekannte Zielwerte leiten das Lernen aus den Eingabemerkmalen an.
Kategorien führen zur Klassifikation, zahlenmäßig bestimmte Größen zur Regression.
Training dient dem Lernen, Validierung der Auswahl und Testen der abschließenden Bewertung.
Entscheidend sind brauchbare Vorhersagen auf neuen, passenden Daten.
Sehr gute Trainingsleistung bei deutlich schlechterer Leistung auf unabhängigen, passenden Prüfdaten ist ein Warnsignal, kein Beweis. Auch die Datenauswahl muss geprüft werden.
Ziel, verfügbare Merkmale, bekannte Labels und eine zur Anwendung passende Prüfung gehören zusammen.
Paketlaufzeiten vorhersagen – ein erfundener Plan
- 1Wir wollen die Laufzeit eines Pakets vorhersagen: die Dauer von der Abgabe bis zur Ankunft in Stunden.
- 2Als Merkmale wählen wir die Versandart und die Entfernung. Beide Angaben müssen schon bei der Vorhersage verfügbar sein.
- 3Für vergangene, abgeschlossene Sendungen brauchen wir diese Merkmale und die bekannten Laufzeiten als Labels. Die Laufzeit ist eine Messgröße; die Aufgabe ist Regression.
- 4Jede Sendung erscheint einmal. Wir nutzen frühere Sendungen zum Training, danach liegende zur Validierung und noch spätere zum Testen. Die Teile sollen die vorgesehenen Versandbedingungen ausreichend abdecken.
- 5Wir trainieren mit den Trainingsdaten und wählen Einstellungen anhand der Validierungsdaten. Die Testdaten beeinflussen diese Auswahl nicht.
- 6Zum Abschluss erhält das Modell die Merkmale der Testsendungen. Wir vergleichen seine Vorhersagen mit deren zurückgehaltenen Laufzeiten und betrachten die Abstände in Stunden.
- 7Wir vergleichen Trainings- und Testleistung. Ist die Trainingsleistung sehr gut und die Testleistung deutlich schlechter, ist das ein Warnsignal, kein Beweis für Überanpassung. Wir prüfen auch Umfang und Zusammensetzung der Daten.
Fehler finden
Fehler in Zeile 3Die Auswahl anhand der Testdaten würde die Abschlussprüfung beeinflussen. Richtig: Zwischen Einstellungen wählen wir anhand der Validierungsdaten.
Lückentext
Ein Modell soll Dokumente den vorgegebenen Kategorien „Rechnung“ und „Brief“ zuordnen. Das ist . Du vergleichst nach dem Training mehrere Einstellungen, um eine davon auszuwählen. Dafür dienen im beschriebenen Holdout-Vorgehen die . Ein Modell ist auf Trainingsdaten sehr gut, auf unabhängigen, passenden neuen Daten deutlich schlechter. Dieser Abstand ist für Überanpassung.