

SQL lernen: Abfragen, JOINs und Datenänderungen
Du liest Tabellen mit SQL, verknüpfst passende Zeilen, berechnest Gruppensummen und erkennst die Wirkung von UPDATE und DELETE.
Kurz gesagt
Mit SQL fragst du Daten aus Tabellen ab und verknüpfst passende Zeilen mit JOIN. GROUP BY und SUM liefern Gruppensummen. Bei einfachen UPDATE- und DELETE-Anweisungen fehlt ohne WHERE die Zeilenauswahl; zusätzliche Regeln können die Ausführung verhindern oder beeinflussen.
Eine Datenbank speichert geordnete Daten, zum Beispiel in Tabellen. SQL bedeutet „Structured Query Language“, auf Deutsch etwa „strukturierte Abfragesprache“: Damit liest und bearbeitest du solche Daten. Eine Anweisung ist ein einzelner Auftrag; eine Abfrage liest Daten und liefert eine Ergebnistabelle. Alle Daten dieser Lektion sind erfunden; die SQL-Anweisungen gelten für PostgreSQL, ein Programm zum Verwalten von Datenbanken, und setzen die beschriebenen Tabellen voraus.
Deine Lernziele
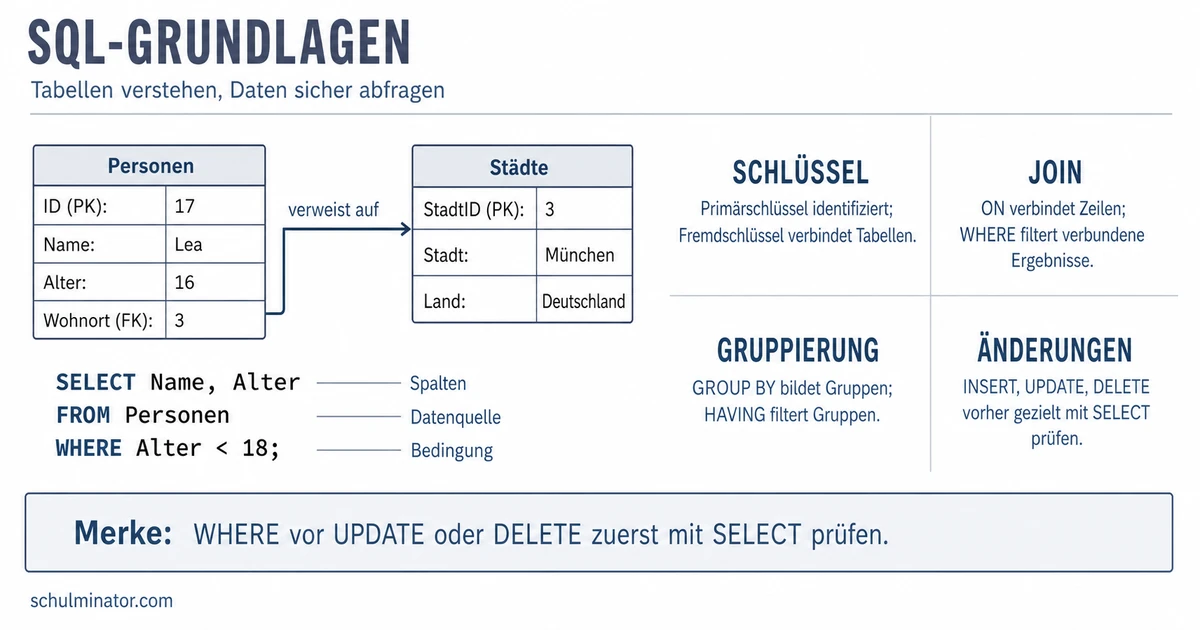
Eine Tabelle ordnet Daten in Spalten und Zeilen. Ein Attribut ist eine benannte Spalte, etwa ziel_id. Ein Datensatz ist eine Zeile mit den zusammengehörenden Werten einer Sendung. Die unten gezeigten Tabellen heißen abholorte und sendungen.
Ein Primärschlüssel kennzeichnet jeden Datensatz eindeutig. Seine Werte dürfen weder doppelt vorkommen noch NULL sein. NULL ist eine besondere Markierung für einen fehlenden Wert, keine leere Zeichenfolge. Eine Tabelle kann höchstens einen Primärschlüssel haben; dieser kann jedoch mehrere Spalten gemeinsam umfassen.
Ein Fremdschlüssel verbindet Tabellen durch eine gespeicherte Beziehung: Ein vorhandener Verweis muss zu einem Schlüsselwert der Zieltabelle passen. Das Ziel muss durch einen Primärschlüssel oder eine andere passende Eindeutigkeitsregel für die gesamte Zieltabelle abgesichert sein. Ein Fremdschlüssel kann mehrere Spalten umfassen und auch auf dieselbe Tabelle verweisen.
NULL braucht eine eigene Regel: Bei einem einspaltigen Fremdschlüssel verlangt NULL normalerweise keinen passenden Zielwert. Bei mehreren Fremdschlüsselspalten reicht dafür normalerweise bereits ein NULL. Die zusätzliche PostgreSQL-Regel MATCH FULL erlaubt diese Ausnahme dagegen nur, wenn sämtliche beteiligten Werte NULL sind. Die Regel NOT NULL verbietet NULL in einer Spalte.
Im Beispiel ist ort_id der Primärschlüssel von abholorte. sendung_id ist der Primärschlüssel von sendungen. ziel_id ist dort ein Fremdschlüssel auf abholorte.ort_id; der Punkt trennt Tabellenname und Spaltenname. Mehrere Sendungen dürfen denselben Zielort haben. Für ziel_id gibt es hier keine zusätzliche Regel, die doppelte Werte verbietet.
| abholorte: ort_id | ort |
|---|---|
| 4 | Nord |
| 9 | Süd |
| sendungen: sendung_id | ziel_id |
|---|---|
| 101 | 4 |
| 102 | 4 |
| 103 | 9 |
Schlüssel
Ein Primärschlüssel identifiziert eine Zeile eindeutig und ohne NULL. Ein Fremdschlüssel sichert passende Verweise auf dafür geeignete Schlüsselwerte; für NULL gelten besondere Regeln.
Teste dich
SELECT nennt die Spalten, die du ausgeben möchtest. FROM nennt die Ausgangstabelle. WHERE enthält eine Bedingung und behält die Zeilen, für die sie wahr ist. Bei falsch oder NULL wird die Zeile verworfen. Ohne WHERE entfällt dieser Filter. Die hier verwendeten SELECT-Abfragen verändern die gespeicherten Daten nicht.
In SQL trennt ein Komma mehrere Ausgabespalten. Ein Punkt verbindet Tabellenname und Spaltenname. Das Zeichen = prüft in einer Bedingung auf Gleichheit. Textwerte stehen in einfachen Anführungszeichen, etwa 'West'. Ein Semikolon beendet die Anweisung.
Ein JOIN verknüpft Tabellen. Hier verwenden wir INNER JOIN: Für jedes Zeilenpaar, das die Bedingung hinter ON erfüllt, entsteht eine Ergebniszeile. Eine Ausgangszeile kann deshalb mehrere passende Partner haben. Gibt es keinen passenden Partner, trägt sie keine Ergebniszeile bei. Die Spalten müssen fachlich zusammenpassen; gleiche Spaltennamen oder ein eingerichteter Fremdschlüssel sind dafür nicht erforderlich.
In den erfundenen Daten unten nennt standort_id den Raum eines Geräts. In raeume ist raum_id der Primärschlüssel. Die Verknüpfung vergleicht geraete.standort_id mit raeume.raum_id. Anschließend lässt WHERE die Zeilen für den Bereich „West“ durch. Die ersten vier Zeilen des Beispiels bilden zusammen eine ausführbare SQL-Abfrage. Ohne zusätzliche Sortieranweisung ist die Reihenfolge der Ergebniszeilen nicht festgelegt; Ergebnisangaben dieser Lektion beschreiben daher keine feste Reihenfolge.
| geraete: geraet_id | modell | standort_id |
|---|---|---|
| 21 | Scanner | 3 |
| 22 | Drucker | 3 |
| 23 | Plotter | 8 |
| raeume: raum_id | bereich |
|---|---|
| 3 | West |
| 8 | Ost |
Beispiel: Geräte eines Bereichs abfragen
- 1SELECT geraete.modell, raeume.bereich
- 2FROM geraete
- 3INNER JOIN raeume ON geraete.standort_id = raeume.raum_id
- 4WHERE raeume.bereich = 'West';
- 5Ergebnis: eine Zeile mit Scanner und West sowie eine Zeile mit Drucker und West.
Teste dich
GROUP BY fasst Zeilen mit gleichen Werten in den genannten Spalten zu Gruppen zusammen. Eine Aggregatfunktion berechnet aus mehreren Zeilen einen zusammengefassten Wert. SUM ist eine solche Funktion: SUM(kilo) addiert die Werte der Spalte kilo innerhalb einer Gruppe. Für sämtliche Summenaufgaben dieser Lektion sind die verwendeten Werte ganze Zahlen ohne NULL; jede ausgewertete Gruppe enthält mindestens eine Zeile.
In einer einfachen Abfrage wird zuerst die Datenquelle bestimmt. WHERE filtert daraus Zeilen. GROUP BY gruppiert die verbliebenen Zeilen. Danach liefert SUM für jede Gruppe deren Summe. Verwendest du eine Aggregatfunktion ohne GROUP BY, werden die nach dem Filter verbliebenen Zeilen als eine gemeinsame Gruppe ausgewertet.
Wenn du GROUP BY oder eine Aggregatfunktion verwendest, muss eine einzeln ausgegebene Spalte grundsätzlich auch in GROUP BY stehen. Einzeln bedeutet hier: außerhalb einer Aggregatfunktion. Die hier erklärte Ausnahme in PostgreSQL gilt, wenn der vollständige Primärschlüssel ihrer Tabelle in GROUP BY steht. Dann dürfen auch weitere Spalten dieser Tabelle einzeln ausgegeben werden, denn der Primärschlüssel legt die übrigen Werte der Tabellenzeile eindeutig fest. Ohne passende Gruppierung oder diese Ausnahme könnte eine Gruppe mehrere unterschiedliche Werte für die einzelne Ausgabespalte enthalten.
Die erfundene Tabelle ernte enthält die Spalten sorte und kilo. kilo speichert die Masse in Kilogramm. Die beiden Apfelzeilen bilden eine Gruppe; die Birnenzeile bildet eine andere. AS vergibt einen Namen für eine Ergebnisspalte: AS gesamt nennt die Summenspalte „gesamt“.
| ernte: sorte | kilo |
|---|---|
| Apfel | 6 |
| Birne | 4 |
| Apfel | 3 |
Beispiel: Erntemengen je Sorte zusammenfassen
- 1SELECT sorte, SUM(kilo) AS gesamt
- 2FROM ernte
- 3GROUP BY sorte;
- 4Die Apfelgruppe enthält 6 und 3 Kilogramm. Ihre Summe beträgt 9 Kilogramm.
- 5Ergebnis: Apfel mit gesamt 9 und Birne mit gesamt 4.
Merke: GROUP BY bestimmt die Gruppen. SUM berechnet einen Wert je Gruppe. Einzeln ausgegebene Spalten müssen grundsätzlich in GROUP BY stehen. Die hier erklärte Ausnahme gilt für weitere Spalten einer Tabelle, deren vollständiger Primärschlüssel in GROUP BY steht.
Teste dich
UPDATE bearbeitet vorhandene Datensätze. Hinter SET stehen die Spalten und ihre neuen Werte. In SET ist = eine Zuweisung: Der rechts stehende Wert soll in die links genannte Spalte geschrieben werden. Nicht genannte Spalten behalten ihre Werte. DELETE FROM entfernt dagegen ganze Datensätze; der Aufbau der Tabelle bleibt erhalten.
Bei beiden Anweisungen begrenzt WHERE die betroffenen Zeilen auf diejenigen, für die die Bedingung wahr ist. In einer einfachen Anweisung ohne WHERE fehlt diese Zeilenauswahl. Dann richtet sich UPDATE an jede Zeile und setzt dort die genannten Spalten. DELETE richtet sich an sämtliche Zeilen und leert bei erfolgreicher Ausführung die Tabelle. PostgreSQL verlangt vor einem solchen DELETE keine zusätzliche Bestätigung.
Diese Aussagen sind keine ausnahmslose Erfolgsgarantie. Eine gespeicherte Regel, auch Constraint genannt, kann eine unzulässige Änderung verhindern. Beispielsweise kann ein Primärschlüssel keinen doppelten Wert annehmen. Eine Fremdschlüsselregel kann das Löschen einer noch referenzierten Zeile verhindern, etwa mit der Einstellung RESTRICT. Ein Trigger ist eine automatisch ausgelöste Zusatzaktion; bestimmte Trigger können einzelne UPDATE-Bearbeitungen unterdrücken. Außerdem kann ein UPDATE denselben Wert zuweisen, der bereits gespeichert ist: Eine bearbeitete Zeile muss deshalb keinen anderen Inhalt bekommen.
Die folgenden Ausführungen verwenden einfache Übungstabellen ohne solche unterdrückenden Zusatzaktionen. Die Anweisungen laufen erfolgreich. In lampen gibt es anfangs die Zeilen mit lampen_id 31 und 32; beide haben status 'aus'. Die beiden Anweisungen im Beispiel werden nacheinander ausgeführt. Datenänderungen probierst du in einer eigenen Übungsdatenbank mit erfundenen Daten aus.
Beispiel: Eine Lampe bearbeiten und eine andere entfernen
- 1UPDATE lampen SET status = 'an' WHERE lampen_id = 31;
- 2Danach hat Lampe 31 den Status 'an'. Lampe 32 behält den Status 'aus'. Die lampen_id bleibt jeweils erhalten.
- 3DELETE FROM lampen WHERE lampen_id = 32;
- 4Danach enthält lampen die Zeile für Lampe 31. Die Zeile für Lampe 32 wurde entfernt.
Merke: Ohne WHERE fehlt bei einfachen UPDATE- und DELETE-Anweisungen die Zeilenauswahl. UPDATE betrifft die in SET genannten Spalten; DELETE entfernt Zeilen. Erfolg und Wirkung hängen auch von gespeicherten Regeln und Zusatzaktionen ab.
Teste dich
Alles auf einen Blick
SQL
Attribute sind Spalten, Datensätze sind Zeilen. Primärschlüssel identifizieren Zeilen; Fremdschlüssel sichern passende Verweise mit besonderen NULL-Regeln.
SELECT bestimmt die Ausgabe, FROM die Quelle und WHERE die Zeilenauswahl durch eine wahre Bedingung.
INNER JOIN liefert passende Zeilenpaare. Verschiedene Spaltennamen und mehrere Partner je Ausgangszeile sind möglich.
GROUP BY gruppiert gleiche Werte. SUM addiert je Gruppe. Einzelne Ausgabespalten müssen grundsätzlich gruppiert sein; die erklärte Ausnahme setzt den vollständigen Primärschlüssel ihrer Tabelle in GROUP BY voraus.
Ohne WHERE fehlt bei einfachen UPDATE- und DELETE-Anweisungen die Zeilenauswahl. SET bestimmt die zu bearbeitenden Spalten; Regeln und Zusatzaktionen können die Wirkung begrenzen.
Bauteilmengen einer Farbe zusammenrechnen
- 1Erfundene Daten: bauteile hat die Spalten farbe und menge. Eine Zeile enthält 'gelb' und 3, eine 'blau' und 7 und eine weitere 'gelb' und 5.
- 2Gesucht ist die Gesamtmenge für 'gelb'. WHERE farbe = 'gelb' behält dafür die Zeilen mit den Mengen 3 und 5.
- 3GROUP BY farbe fasst diese beiden Zeilen zur gelben Gruppe zusammen. SUM(menge) addiert deren Mengen.
- 4Die ausführbare Abfrage lautet: SELECT farbe, SUM(menge) AS gesamt FROM bauteile WHERE farbe = 'gelb' GROUP BY farbe;
- 5Das Ergebnis enthält eine Zeile: farbe hat den Wert 'gelb', gesamt den Wert 8. Die blaue Menge 7 gehört nicht zum Ergebnis.
Fehler finden
Fehler in Zeile 3Ohne WHERE fehlt die Auswahl einer bestimmten Zeile. Richtig: Die Anweisung löscht unter den genannten Voraussetzungen alle drei Zeilen aus plaene.
Lückentext
In einer Tabelle ist jede Zeile ein . Beim INNER JOIN bleibt ein Zeilenpaar erhalten, wenn seine ON-Bedingung ist. Bei GROUP BY mit mehreren Zeilen je Gruppe summiert SUM die Werte .