

SQL SELECT: Daten gezielt abfragen
Du wählst mit SELECT Daten aus, filterst und sortierst Ergebnisse, verbindest Tabellen und wertest Gruppen aus.
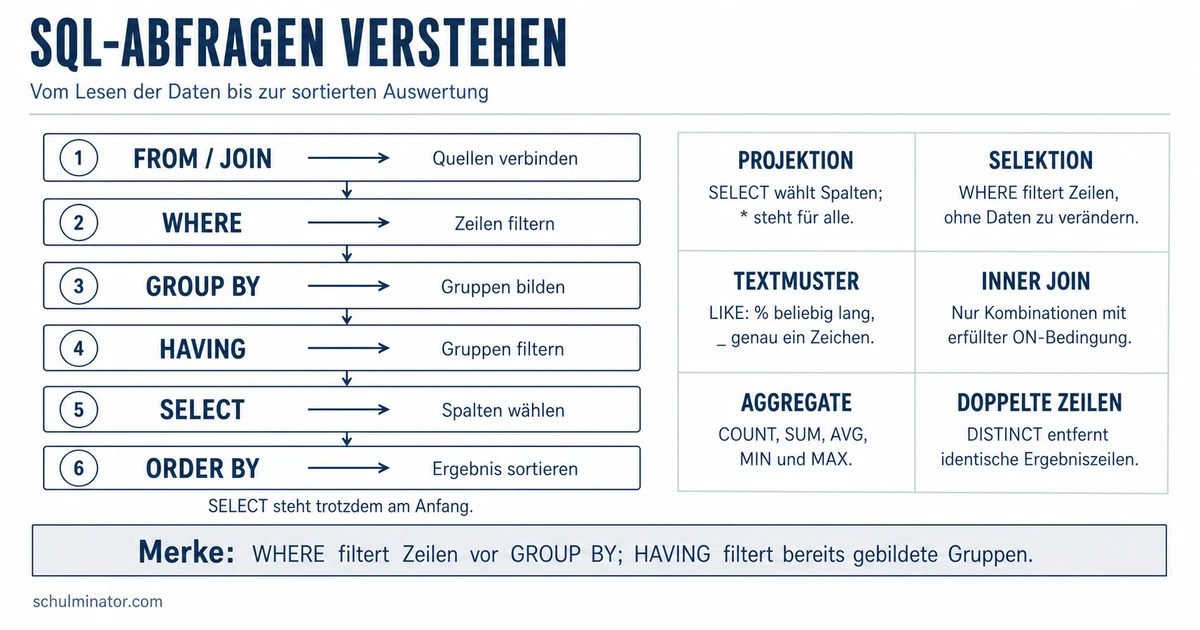
Kurz gesagt
Mit SELECT fragst du Daten aus Tabellen ab. In PostgreSQL kannst du Spalten auswählen, Zeilen filtern, Ergebnisse sortieren, Tabellen verbinden und Werte für Gruppen zusammenfassen.
SQL steht für Structured Query Language, also strukturierte Abfragesprache. Diese Lektion folgt PostgreSQL, einem Datenbankmanagementsystem, das Daten in Tabellen verwaltet. Alle Übungsdaten sind erfunden; die genannten Tabellen und Spalten gelten als vorhanden. Zahlenspalten enthalten in den Beispielen ganze Zahlen ohne fehlende Werte.
Deine Lernziele
Eine Tabelle besteht aus Spalten und Zeilen. Eine Spalte enthält eine bestimmte Art von Angaben, etwa eine Kennung oder eine Leistung. Eine Zeile enthält die zusammengehörenden Angaben zu einem Eintrag.
SELECT bestimmt die ausgegebenen Spalten oder berechneten Ausdrücke. Mehrere Spaltennamen trennst du durch Kommas. FROM nennt die Tabelle, aus der die Daten stammen. WHERE legt eine Bedingung für die einzelnen Zeilen fest. Das Zeichen > bedeutet in einer solchen Bedingung „größer als“; der Grenzwert selbst zählt nicht mit. >= bedeutet „größer oder gleich“. Ein Semikolon beendet die SQL-Anweisung.
WHERE behält eine Zeile, wenn ihre Bedingung wahr ist. Ist die Bedingung falsch oder unbekannt, wird die Zeile verworfen. NULL kennzeichnet einen fehlenden oder unbekannten Wert; auch das Ergebnis einer Bedingung kann NULL und damit unbekannt sein. Die ausgegebenen Spalten müssen nicht dieselben sein wie die Spalten, die WHERE prüft. Eine Abfrage liefert ein Ergebnis, ohne dadurch die gespeicherten Daten zu ändern.
SELECT, FROM und WHERE
SELECT bestimmt die Ausgabe, FROM die Datenquelle und WHERE die Bedingung für einzelne Zeilen.
| kennung | art | leistung |
|---|---|---|
| 11 | Lampe | 6 |
| 12 | Lampe | 9 |
| 13 | Radio | 4 |
Beispiel: Geräte nach ihrer Leistung auswählen
- 1Die erfundene Tabelle geraete enthält die drei oben gezeigten Zeilen.
- 2SELECT kennung, leistung FROM geraete WHERE leistung > 5;
- 3WHERE behält die Geräte mit den Leistungen 6 und 9.
- 4SELECT gibt die Spalten kennung und leistung aus: (11, 6) und (12, 9). Die Spalte art erscheint nicht.
- 5Die Reihenfolge dieser beiden Ergebniszeilen ist hier nicht festgelegt.
Teste dich
ORDER BY sortiert die Ergebniszeilen nach den angegebenen Spalten oder Ausdrücken. ASC bedeutet aufsteigend, bei Zahlen also vom kleineren zum größeren Wert. DESC bedeutet absteigend. Ohne Richtungsangabe gilt ASC. Ohne ORDER BY ist keine bestimmte Reihenfolge zugesichert.
Bei mehreren Sortierangaben entscheidet zuerst die linke Angabe. Stimmen zwei Zeilen dort überein, entscheidet die nächste Angabe. ASC oder DESC gilt jeweils für den Ausdruck unmittelbar davor. ORDER BY zone, gewicht DESC sortiert deshalb zone aufsteigend und bei gleicher zone gewicht absteigend. Stimmen Zeilen in allen Sortierangaben überein, ist ihre gegenseitige Reihenfolge nicht festgelegt.
SELECT DISTINCT entfernt doppelte vollständige Ergebniszeilen: Von jeder mehrfach vorkommenden Ergebniszeile bleibt eine erhalten. Gleiche Werte in einer einzelnen Spalte dürfen weiterhin mehrfach vorkommen, wenn sich andere ausgegebene Werte unterscheiden. DISTINCT ändert keine gespeicherten Tabelleneinträge und legt keine Sortierung fest. Ohne DISTINCT bleiben doppelte Ergebniszeilen grundsätzlich erhalten.
| zone | gewicht |
|---|---|
| 2 | 5 |
| 1 | 8 |
| 2 | 5 |
| 1 | 3 |
Beispiel: Verschiedene Paketangaben geordnet ausgeben
- 1Die erfundene Tabelle pakete enthält die vier oben gezeigten Zeilen.
- 2SELECT DISTINCT zone, gewicht FROM pakete ORDER BY zone ASC, gewicht DESC;
- 3Die Ergebniszeile (2, 5) kommt zunächst zweimal vor. DISTINCT behält davon eine.
- 4Zuerst stehen die Zeilen der Zone 1, dort mit Gewicht 8 vor Gewicht 3.
- 5Die vollständige Ausgabe lautet: (1, 8), (1, 3), (2, 5).
Merke: DISTINCT vergleicht die gesamte ausgegebene Zeile. ORDER BY bestimmt die Reihenfolge. Beide erfüllen unterschiedliche Aufgaben.
Teste dich
Ein Attribut ist eine benannte Eigenschaft, die in einer Tabelle als Spalte erscheint. Ein JOIN verbindet Zeilen aus Tabellen. Bei einem INNER JOIN entsteht für jedes Zeilenpaar eine Ergebniszeile, wenn die Bedingung hinter ON wahr ist. JOIN ohne weiteren Zusatz bedeutet INNER JOIN.
In unserem Beispiel beschreibt das gemeinsame Attribut eine Kursnummer. Die Spalten heißen kurs_id und kurs_nr: Gleiche Spaltennamen sind für eine Verbindung mit ON nicht erforderlich. Die Werte müssen passend vergleichbar sein. Das Zeichen = prüft hier, ob zwei Werte gleich sind. Mehrere passende Zeilen auf der anderen Seite erzeugen mehrere Treffer. Ohne passenden Partner erscheint eine Zeile beim INNER JOIN nicht.
AS vergibt einen kurzen Ersatznamen, auch Alias genannt. In FROM kurse AS k steht k für die Tabelle kurse. k.kurs_id meint die Spalte kurs_id dieser Tabelle. Solche Angaben machen deutlich, aus welcher Tabelle eine Spalte stammt. Heißen die Verbindungsspalten auf beiden Seiten gleich, kann USING (kurs_id) die Bedingung ON k.kurs_id = a.kurs_id abkürzen. Bei unterschiedlichen Spaltennamen verwendest du diese Abkürzung nicht.
Es gibt weitere Verbindungsarten: LEFT JOIN behält zusätzlich Zeilen der linken Tabelle ohne passenden Partner. Die Spalten der rechten Tabelle erhalten dort NULL. RIGHT JOIN behält entsprechend die partnerlosen Zeilen der rechten Tabelle und ergänzt links NULL. FULL JOIN behält die partnerlosen Zeilen beider Seiten und ergänzt jeweils die fehlende Seite mit NULL. Diese Formen heißen auch LEFT OUTER JOIN, RIGHT OUTER JOIN und FULL OUTER JOIN; OUTER darf jeweils entfallen.
| kurse: kurs_id | bezeichnung |
|---|---|
| 21 | Keramik |
| 22 | Tanz |
| 23 | Schach |
| anmeldungen: kurs_nr | platz |
|---|---|
| 21 | 4 |
| 21 | 9 |
| 24 | 2 |
Beispiel: Kurse und angemeldete Plätze verbinden
- 1Die beiden Tabellen enthalten die oben gezeigten erfundenen Daten.
- 2SELECT k.bezeichnung, a.platz FROM kurse AS k INNER JOIN anmeldungen AS a ON k.kurs_id = a.kurs_nr;
- 3Die Kursnummer 21 findet zwei Partner: die Plätze 4 und 9.
- 4Die Ausgabe enthält (Keramik, 4) und (Keramik, 9), ohne festgelegte Reihenfolge.
- 5Die Kurse 22 und 23 sowie die Anmeldung zu Kurs 24 haben keinen passenden Partner und erscheinen in diesem INNER JOIN nicht.
Teste dich
GROUP BY fasst Zeilen mit gleichen Werten in den angegebenen Gruppenspalten zusammen. Eine Aggregatfunktion berechnet aus den Werten mehrerer Zeilen einen gemeinsamen Wert. SUM(menge) addiert die Zahlen der Spalte menge. Mit GROUP BY geschieht das getrennt für jede Gruppe. AS kann dem berechneten Ergebnis eine Spaltenüberschrift geben, etwa SUM(menge) AS gesamt.
WHERE prüft einzelne Zeilen vor dem Gruppieren. HAVING prüft die entstandenen Gruppen, etwa anhand ihrer Summe. Eine Bedingung wie menge >= 2 gehört beim Filtern einzelner Einträge zu WHERE. Eine Bedingung wie SUM(menge) >= 6 gehört beim Filtern der Gruppen zu HAVING. Diese Schritte beschreiben die logische Bedeutung der Abfrage, keinen fest vorgeschriebenen technischen Ausführungsplan.
In einer einfachen gruppierten Abfrage gibst du in SELECT die Gruppenspalten und Ergebnisse von Aggregatfunktionen aus. Eine andere, nicht gruppierte Spalte hätte möglicherweise mehrere verschiedene Werte pro Gruppe. PostgreSQL erlaubt eine Ausnahme: Enthält GROUP BY den Primärschlüssel einer Tabelle, dürfen auch weitere Spalten dieser Tabelle ohne Aggregatfunktion verwendet werden. Der Primärschlüssel identifiziert jede Tabellenzeile eindeutig; dadurch sind deren weitere Werte eindeutig bestimmt. Diese Gruppierungsregeln gelten auch für Spalten in HAVING außerhalb von Aggregatfunktionen.
Enthält eine Abfrage Aggregatfunktionen ohne GROUP BY, werden alle nach WHERE verbliebenen Zeilen als eine Gruppe behandelt. Auch HAVING ohne GROUP BY macht die Abfrage zu einer gruppierten Abfrage mit einer solchen Gesamtgruppe. Tabellenspalten dürfen dann in SELECT und HAVING nur innerhalb von Aggregatfunktionen stehen. Ist die HAVING-Bedingung wahr, entsteht eine Ergebniszeile, andernfalls keine.
| lager | menge |
|---|---|
| Ost | 2 |
| Ost | 5 |
| West | 4 |
| West | 1 |
| Nord | 6 |
Beispiel: Liefermengen je Lager zusammenfassen
- 1Die erfundene Tabelle lieferungen enthält die fünf oben gezeigten Zeilen.
- 2SELECT lager, SUM(menge) AS gesamt FROM lieferungen WHERE menge >= 2 GROUP BY lager HAVING SUM(menge) >= 6 ORDER BY SUM(menge) DESC;
- 3WHERE entfernt den Eintrag West mit Menge 1.
- 4GROUP BY bildet Lagergruppen. SUM ergibt Ost: 7, West: 4 und Nord: 6.
- 5HAVING behält Ost und Nord. ORDER BY sortiert nach absteigender Summe.
- 6Die Ausgabe mit den Spalten lager und gesamt lautet: (Ost, 7), (Nord, 6).
Merke: WHERE entscheidet, welche einzelnen Zeilen in die Auswertung eingehen. HAVING entscheidet, welche Gruppen im Ergebnis bleiben.
Teste dich
Alles auf einen Blick
SQL SELECT
SELECT bestimmt die Ausgabespalten, FROM die Datenquelle und WHERE die zugelassenen Zeilen.
ORDER BY vergleicht die Angaben von links nach rechts; ohne Richtungsangabe gilt ASC.
DISTINCT behält eine Zeile je gleicher vollständiger Ergebniszeile und ändert keine gespeicherten Daten.
INNER JOIN erzeugt für jedes passende Zeilenpaar einen Treffer; gleiche Spaltennamen sind bei ON nicht nötig.
GROUP BY fasst gleiche Gruppenwerte zusammen; SUM addiert die Zahlen je Gruppe.
WHERE filtert einzelne Zeilen vor der Gruppierung, HAVING die entstandenen Gruppen.
Raumstunden auswerten
- 1Die erfundene Tabelle buchungen enthält (raum, stunden): (4, 2), (4, 3), (7, 1), (7, 4), (9, 2).
- 2Gesucht sind Räume mit mindestens 4 Stunden insgesamt. Einzelbuchungen unter 2 Stunden sollen vorher entfallen. Die größte Summe soll zuerst erscheinen.
- 3SELECT raum, SUM(stunden) AS gesamt FROM buchungen WHERE stunden >= 2 GROUP BY raum HAVING SUM(stunden) >= 4 ORDER BY SUM(stunden) DESC;
- 4WHERE entfernt die Buchung (7, 1). Die übrigen vier Buchungen gehen in die Gruppen ein.
- 5Die Summen sind 5 für Raum 4, 4 für Raum 7 und 2 für Raum 9.
- 6HAVING entfernt Raum 9. Die absteigend sortierte Ausgabe mit den Spalten raum und gesamt lautet: (4, 5), (7, 4).
Fehler finden
Fehler in Zeile 4Die Bedingung prüft eine Gruppensumme, keine einzelne Zeile. Richtig: Die Bedingung SUM(menge) > 6 steht in HAVING.
Lückentext
In einer erfundenen Tabelle stehen die Zahlen 3 und 9 in der Spalte wert. WHERE wert > 5 behält die Zeile mit . Bei ORDER BY wert ASC steht von den Werten 2, 7 und 4 zuerst . Sollen nach dem Gruppieren die Gruppen mit SUM(menge) > 10 übrig bleiben, steht diese Bedingung hinter .