

Unicode einfach erklärt: Codepunkte und UTF-8
Du lernst, wie Zeichen gespeichert werden, wie du Text mit einer Zeichentabelle umwandelst und wie du Ursachen für Textfehler erkennst.
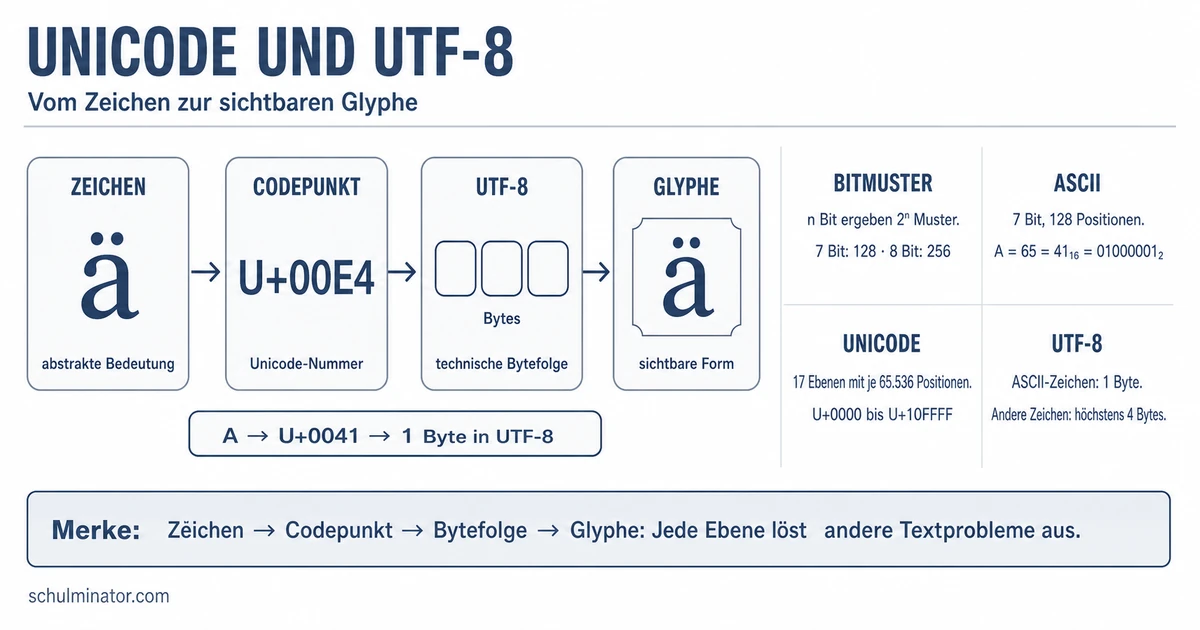
Kurz gesagt
Unicode ordnet Zeichen Nummern zu, die Codepunkte heißen. UTF-8 legt fest, wie solche Nummern als Bytes gespeichert werden. Ein sichtbares Zeichen kann mehrere Codepunkte brauchen.
Du tippst ein Zeichen, doch ein Computer speichert dazu Zahlen. Wir verfolgen diesen Weg und verwenden eine kleine Zeichentabelle. Danach prüfst du, weshalb Text manchmal falsch aussieht.
Deine Lernziele
Unicode ist ein Standard, also eine gemeinsame Festlegung, für Zeichen und ihre Nummern. Eine solche Nummer heißt Codepunkt. Ein Bit ist eine einzelne 0 oder 1. Acht Bits bilden ein Byte. Eine Bytefolge besteht aus einem oder mehreren Bytes in einer bestimmten Reihenfolge.
Eine Codierung legt fest, wie aus Codepunkten gespeicherte Bytes werden. UTF-8 ist eine solche Codierung. UTF bedeutet „Unicode Transformation Format“, also ein Umwandlungsverfahren für Unicode. Die 8 verweist auf die acht Bits eines Bytes. UTF-8 braucht pro codiertem Codepunkt ein bis vier Bytes. Unicode enthält auch besondere Nummern, die für eine andere Unicode-Codierung reserviert sind. Sie heißen Surrogat-Codepunkte und werden nicht mit UTF-8 codiert.
Die Nummern und Bytes schreiben wir hier hexadezimal. Das ist eine Zahlenschreibweise mit 16 Ziffern: 0 bis 9 und A bis F. A bis F stehen für die Werte zehn bis fünfzehn. U+ kennzeichnet eine Unicode-Nummer in dieser Schreibweise. Bei den Byteangaben bilden jeweils zwei Ziffern ein Byte. Du brauchst die Werte hier nicht umzurechnen, sondern schlägst sie nach.
Codepunkt
Ein Codepunkt ist eine Nummer in Unicode. Die Nummer eines Zeichens und die dazu gespeicherten Bytes sind unterschiedliche Angaben.
Beispiel: Den griechischen Buchstaben „Ω“ speichern
- 1Das Zeichen „Ω“ ist ein griechischer Buchstabe.
- 2Unicode ordnet ihm den Codepunkt U+03A9 zu.
- 3UTF-8 macht daraus die Bytefolge CE A9.
- 4CE und A9 schreiben jeweils ein Byte. Zusammen sind es zwei Bytes.
Merke: Ein sichtbares Zeichen kann mehrere Codepunkte benötigen. Die Grenze von vier Bytes gilt pro codiertem Codepunkt, nicht pro sichtbarem Zeichen. In unserer Zeichentabelle verwenden wir für jedes Zeichen genau einen Codepunkt.
Teste dich
ASCII bedeutet „American Standard Code for Information Interchange“, ungefähr „Amerikanischer Standardcode für den Austausch von Informationen“. ASCII ist ein Zeichencode: Er ordnet ausgewählten Zeichen Zahlen zum Speichern zu. Er umfasst 128 Positionen von 0 bis 127. Dazu gehören die Buchstaben A bis Z und a bis z sowie die Ziffern 0 bis 9. Die Zeichen „ä“, „Ω“, „€“ und „𝄞“ gehören nicht dazu. ASCII kann sie nicht unverändert codieren.
Die ersten 128 Unicode-Positionen stimmen mit ASCII überein. Beim Speichern in Bytes verwendet UTF-8 für diese Positionen jeweils ein Byte mit demselben Wert wie ASCII. Für andere Codepunkte kann UTF-8 mehrere Bytes brauchen. Unicode legt die Codepunkte fest; UTF-8 legt die dazugehörigen Bytes fest. Unicode ist deshalb keine Festlegung auf ein Byte pro Zeichen.
| Name | Aufgabe | Beispiel |
|---|---|---|
| ASCII | Ordnet einem begrenzten Zeichenvorrat Codes zu. | „y“ → 79; „ä“ fehlt. |
| Unicode | Legt Codepunkte für Zeichen fest. | „ä“ → U+00E4 |
| UTF-8 | Ordnet Codepunkten Bytefolgen zu. | U+00E4 → C3 A4 |
Merke: Ein Zeichen kann in Unicode vorkommen und trotzdem in ASCII fehlen. UTF-8 kann den Codepunkt von „ä“ mit den beiden Bytes C3 A4 speichern.
Teste dich
Eine Zeichenfolge ist eine Reihe von Zeichen. Codieren heißt hier: Du suchst zu jedem Zeichen die UTF-8-Bytes und hängst die gefundenen Bytefolgen in derselben Reihenfolge aneinander. Verwende dafür genau die Codepunkte der Tabelle. Sie enthält Buchstaben, das Eurozeichen „€“ und das Musikzeichen „𝄞“.
Decodieren ist der Rückweg: Du liest die Bytes von links nach rechts. Suche jeweils die vollständige Bytefolge eines Tabellenzeichens. Danach gehst du beim nächsten Byte weiter. In dieser Tabelle beginnt keine längere Bytefolge mit der vollständigen Bytefolge eines anderen Tabellenzeichens. Dadurch ist die Aufteilung eindeutig.
Alle Byteangaben sind weiterhin hexadezimal. Zwei Ziffern schreiben ein Byte. Die Leerzeichen zwischen den Byteangaben helfen beim Lesen. Sie stehen hier nicht für gespeicherte Leerzeichen im Text.
| Zeichen | Codepunkt | UTF-8-Bytes |
|---|---|---|
| „y“ | U+0079 | 79 |
| „ä“ | U+00E4 | C3 A4 |
| „Ω“ | U+03A9 | CE A9 |
| „€“ | U+20AC | E2 82 AC |
| „𝄞“ | U+1D11E | F0 9D 84 9E |
Beispiel: „y€“ mit der Tabelle codieren
- 1Für „y“ findest du das Byte 79.
- 2Für „€“ findest du die drei Bytes E2 82 AC.
- 3Hänge die Folgen in Zeichenreihenfolge aneinander: 79 E2 82 AC.
- 4Die Zeichenfolge „y€“ braucht damit vier Bytes.
Teste dich
Falsch decodiert: Die gespeicherten Bytes können stimmen, während ein Programm sie mit der falschen Codierung liest. Dann ordnet es ihnen falsche Zeichen zu oder ersetzt etwas. Das Ersetzungszeichen „�“ kann zum Beispiel erscheinen, wenn eine Bytefolge beim Lesen nicht als gültiges UTF-8 verstanden wird. Das Zeichen „�“ allein beweist aber keine bestimmte Ursache.
Zeichen nicht enthalten: Eine Codierung kann ein benötigtes Zeichen gar nicht anbieten. ASCII kennt zum Beispiel „ä“, „Ω“, „€“ und „𝄞“ nicht. Soll eines dieser Zeichen unverändert als ASCII gespeichert werden, liegt das Problem bereits beim Codieren. Eine andere Schriftart ergänzt keinen fehlenden ASCII-Code.
Zeichenbild fehlt: Die Bytes können richtig gespeichert und richtig decodiert sein. Trotzdem kann der verwendeten Schriftart das Bild für ein Zeichen fehlen. Dann erscheint oft ein Kästchen, manchmal auch ein anderes Ersatzbild oder eine leere Stelle. Eine Schriftart mit dem benötigten Zeichenbild kann diese Ursache beheben.
Ein Kästchen, ein Fragezeichen oder „�“ genügt nicht, um die Ursache sicher festzustellen. Prüfe zusätzliche Angaben zum Speichern, zum Decodieren und zur Schriftart. Es gibt weitere Ursachen für Darstellungsprobleme; hier unterscheiden wir diese drei.
Schriftart
Eine Schriftart enthält Zeichenbilder. Sie bestimmt, wie unterstützte Zeichen auf dem Bildschirm aussehen. Ein korrekt gelesener Codepunkt kann vorhanden sein, obwohl der Schriftart sein Zeichenbild fehlt.
Beispiel: Eine erfundene Notiz mit „Ω€“ untersuchen
- 1Die Notiz „Ω€“ wurde korrekt als UTF-8 gespeichert: CE A9 E2 82 AC.
- 2Das Leseprogramm verwendet laut Einstellung eine andere Codierung statt UTF-8.
- 3Es zeigt falsche Zeichen. Für dieses Beispiel ist die Ursache das falsche Decodieren.
Merke: Unterscheide drei Fragen: Kann die gewählte Codierung das Zeichen speichern? Werden die Bytes passend gelesen? Hat die Schriftart das benötigte Zeichenbild?
Teste dich
Alles auf einen Blick
Unicode
Vom Zeichen geht es über den Codepunkt zur gespeicherten Bytefolge.
Der Standard ordnet Zeichen Codepunkte zu; ein sichtbares Zeichen kann mehrere benötigen.
Pro codiertem Codepunkt werden ein bis vier Bytes gespeichert.
Die 128 Positionen stimmen mit den ersten Unicode-Positionen überein und haben in UTF-8 dieselben Bytewerte.
Beim Codieren hängst du Bytefolgen aneinander; beim Decodieren ordnest du vollständige Bytefolgen wieder Zeichen zu.
Fehlende Zeichen in einer Codierung, falsches Decodieren und fehlende Zeichenbilder sind verschiedene Ursachen. Das Aussehen allein beweist keine davon.
„𝄞äΩ“ codieren und zur Kontrolle decodieren
- 1Wir verwenden die Zeichen und Codepunkte der Tabelle für „𝄞äΩ“.
- 2Für „𝄞“ findest du U+1D11E und die vier Bytes F0 9D 84 9E.
- 3Für „ä“ findest du U+00E4 und die zwei Bytes C3 A4.
- 4Für „Ω“ findest du U+03A9 und die zwei Bytes CE A9.
- 5In Zeichenreihenfolge lautet die ganze Bytefolge F0 9D 84 9E C3 A4 CE A9. Sie enthält acht Bytes.
- 6Zur Kontrolle liest du die vollständigen Gruppen zurück: F0 9D 84 9E → „𝄞“, C3 A4 → „ä“, CE A9 → „Ω“. Das ergibt wieder „𝄞äΩ“.
Fehler finden
Fehler in Zeile 3Hier wird ein Codepunkt mit einem Byte verwechselt. Richtig: „𝄞“ hat in unserer Tabelle einen Codepunkt und vier Bytes: F0 9D 84 9E.
Lückentext
Die Angabe U+20AC nennt bei „€“ . Die UTF-8-Bytefolge E2 82 AC für „€“ besteht aus Bytes. Zum unveränderten Speichern von „Ω“ eignet sich .