

Unüberwachtes Lernen: Muster ohne Labels entdecken
Du unterscheidest Lernarten, erkennst Aufgaben ohne vorgegebene Zielangaben und verstehst, wie k-Means Gruppen bildet und warum du sie prüfen musst.
Kurz gesagt
Unüberwachtes Lernen sucht Muster in Daten, ohne für die Lernaufgabe vorgegebene Zielangaben zu nutzen. Es kann ähnliche Daten gruppieren, Auffälligkeiten finden oder Daten mit weniger Größen darstellen. Die Ergebnisse brauchen eine fachliche Prüfung.
Ein Computer kann Daten untersuchen, ohne zu jedem Beispiel die gewünschte Antwort zu kennen. Dabei kann er Ähnlichkeiten und ungewöhnliche Werte entdecken. Du lernst, welche Aufgaben dazu gehören und warum gefundene Gruppen ihre Bedeutung nicht selbst erklären.
Deine Lernziele
Beim maschinellen Lernen gewinnt ein Computer aus Beispieldaten Regeln oder Muster. Ein Algorithmus ist eine festgelegte Folge von Rechenschritten. Als Merkmale bezeichnet man Eigenschaften, mit denen ein Beispiel beschrieben wird, etwa Länge oder Gewicht. Ein Datensatz fasst hier die Merkmalswerte eines Beispiels zusammen. Ein solches Beispiel wird auch Datenpunkt genannt.
Überwachtes Lernen nutzt Beispiele mit vorgegebenen Zielangaben. Eine solche Zielangabe heißt Label. Das kann eine Klasse wie „rund“ oder ein Zahlenwert wie eine bekannte Lieferdauer sein. Das Verfahren lernt, die Zielangabe für weitere Beispiele vorherzusagen. Entscheidend sind die zum Lernen verwendeten Zielangaben, nicht die Art der Eingaben: Bilder, Texte und Zahlen können bei beiden Lernarten vorkommen.
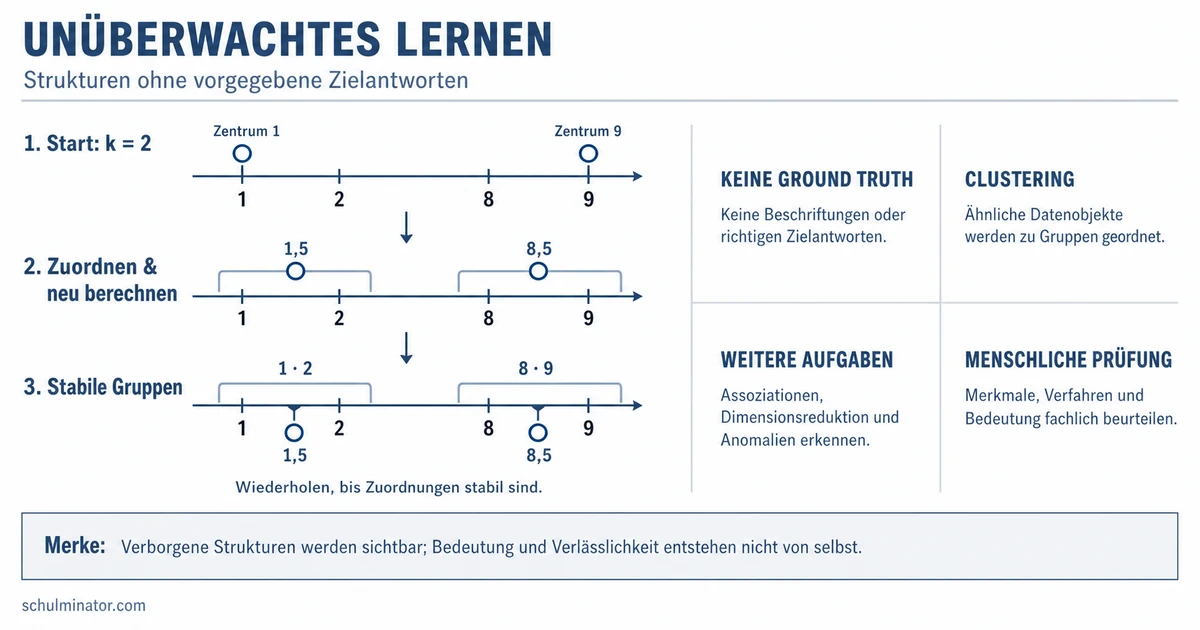
Unüberwachtes Lernen nutzt für die Lernaufgabe keine vorgegebenen Zielangaben. Es sucht stattdessen Strukturen in den gewählten Merkmalen. Beispielsweise kann es ähnliche Datensätze zu Gruppen zusammenfassen. Eine solche Gruppe heißt Cluster. Unüberwacht bedeutet dabei nicht ohne menschliche Entscheidungen: Menschen wählen Daten, Merkmale und Verfahren aus und prüfen die Ergebnisse.
Label
Ein Label ist eine vorgegebene Zielangabe zu einem Lernbeispiel. Es kann eine Klassenzuordnung oder ein Zahlenwert sein.
Beispiel: Geräusche untersuchen (erfundenes Beispiel)
- 1Überwacht: Zu jedem Übungsgeräusch steht die Zielklasse „Klingeln“ oder „Klopfen“ fest. Das Verfahren lernt, diese Klasse vorherzusagen.
- 2Unüberwacht: Die Geräusche haben keine vorgegebenen Zielklassen. Das Verfahren sucht Gruppen anhand gewählter Eigenschaften, etwa Dauer und Lautstärke.
- 3Ein Mensch prüft anschließend, ob die gefundenen Gruppen für die gewünschte Aufgabe nützlich sind.
Teste dich
Die Clusteranalyse teilt Datensätze anhand ihrer Ähnlichkeiten in Gruppen ein. Welche Datensätze ähnlich sind, hängt von den ausgewählten Merkmalen und der verwendeten Vergleichsregel ab. Das gewünschte Ergebnis sind Gruppen.
Die Anomalieerkennung sucht ungewöhnliche einzelne Datensätze. Eine Anomalie oder ein Ausreißer ist ein Datenpunkt, der vom üblichen Muster abweicht. Eine Auffälligkeit beweist keinen Fehler: Sie kann auch eine seltene, aber richtige Beobachtung sein. Das gewünschte Ergebnis sind Hinweise auf auffällige Datenpunkte.
Die Hauptkomponentenanalyse, abgekürzt PCA, stellt Zahlenmerkmale durch neue Größen dar. Eine Dimension bezeichnet hier eine Größe, mit der ein Datenpunkt beschrieben wird. PCA kann die Zahl dieser Größen verringern. Die neuen Größen entstehen aus gewichteten Summen der ursprünglichen Merkmale: Die Merkmalswerte werden mit bestimmten Zahlen multipliziert und dann addiert. Die erste neue Richtung erfasst die größte Streuung, also die stärksten Unterschiede zwischen den Datenpunkten. Weitere Richtungen stehen senkrecht zu den vorherigen und erfassen möglichst viel verbleibende Streuung. Behält man weniger dieser neuen Größen, wird die Darstellung kleiner; dabei kann Information verloren gehen. PCA erzeugt dadurch noch keine Gruppenzuordnung und keine Ausreißermarkierung.
| Aufgabe | Gesuchtes Ergebnis | Erfundener Einsatz |
|---|---|---|
| Clusteranalyse | Gruppen ähnlicher Datensätze | Digitale Spielgegenstände nach Größe und Gewicht gruppieren. |
| Anomalieerkennung | Hinweise auf ungewöhnliche Datenpunkte | Auffällige Werte einer Messreihe kennzeichnen. |
| Hauptkomponentenanalyse | Eine Darstellung mit weniger neuen Größen | Viele zusammenhängende Messgrößen platzsparender darstellen. |
Merke: Unterscheide das gewünschte Ergebnis: Gruppen, auffällige Datenpunkte oder eine Darstellung mit weniger Größen. Mehrere Verfahren können auch nacheinander eingesetzt werden.
Teste dich
k-Means ist ein Verfahren zur Clusteranalyse. Die Zahl k gibt die gewünschte Anzahl der Gruppen und ihrer Zentren an. Ein Zentrum ist der rechnerische Mittelpunkt einer Gruppe. Das Verfahren benötigt Zahlenmerkmale, bei denen Mittelwerte sinnvoll sind. Den Mittelwert erhältst du, indem du die Werte addierst und durch ihre Anzahl teilst. Reine Bezeichnungen wie „Holz“ und „Glas“ eignen sich dafür nicht. Bei mehreren Merkmalen wird jeder Merkmalswert des Zentrums getrennt gemittelt.
Vor einem Durchlauf legst du k fest und wählst entsprechend viele Startzentren, beispielsweise zufällig ausgewählte Datenpunkte. Dann ordnest du jeden Punkt dem nächstgelegenen Zentrum zu. Als Abstand verwenden wir hier die Länge der geraden Verbindung. Anschließend ersetzt du jedes Zentrum durch den Mittelwert seiner zugeordneten Punkte. Zuordnung und Neuberechnung wiederholst du, bis sich die Zuordnungen nicht mehr ändern. Wir betrachten dabei Fälle ohne gleich große Abstände zu zwei Zentren und ohne Gruppen, denen kein Punkt zugeordnet ist. Für solche Sonderfälle müsste eine zusätzliche Regel festgelegt werden.
Die Zahl k wird vorher benötigt, weil schon die erste Zuordnung auf genau diesen Zentren beruht. Sie ist nicht die Anzahl der Merkmale. Du kannst mehrere Durchläufe mit verschiedenen Werten für k vergleichen. Ein ungeeigneter Wert kann Gruppen zusammenlegen oder aufteilen, die für den Zweck anders eingeteilt werden sollten. Kleinere Abstände bei mehr Zentren belegen allein keine nützlichere Einteilung.
Auch die Startzentren beeinflussen das Ergebnis. Ein einzelner Durchlauf garantiert keine bestmögliche Lösung. Außerdem beeinflussen Maßeinheiten und Größenordnungen der Merkmale die Abstände. Deshalb muss ihre Auswahl und Aufbereitung geprüft werden. k-Means ordnet jeden Punkt einer Gruppe zu und liefert dabei keine eigene Ausreißermarkierung. Ausreißer können die Mittelwerte und damit das Ergebnis stark verändern.
Beispiel: Positionen auf einem Übungsfeld gruppieren (erfundenes Beispiel)
- 1Jedes Zahlenpaar beschreibt eine Position in Metern: zuerst den waagerechten, dann den senkrechten Abstand vom Start. Die Punkte sind A → (1;1), B → (1;3), C → (7;1) und D → (7;3).
- 2Wir setzen k=2 und wählen die Startzentren (1;1) und (7;1).
- 3A und B liegen näher am ersten Zentrum, C und D näher am zweiten. So entstehen die Gruppen A mit B und C mit D.
- 4Die neuen Zentren sind (1;2) und (7;2). Beispielsweise ist der zweite Merkmalswert der ersten Gruppe (1+3)/2=2 Meter.
- 5Bei der nächsten Zuordnung bleiben beide Gruppen gleich. Der Durchlauf endet.
- 6Mit k=1 entsteht eine gemeinsame Gruppe mit Zentrum (4;2). Mit k=4 und jedem Datenpunkt als Startzentrum entsteht je eine Gruppe pro Punkt. Welche Einteilung nützlich ist, hängt vom Zweck ab.
Merke: Eine stabile Zuordnung beendet den beschriebenen Durchlauf. Sie beweist weder die bestmögliche Einteilung noch die fachliche Bedeutung der Gruppen.
Teste dich
Eine Clusteranalyse liefert zunächst eine Gruppenzuordnung nach den gewählten Merkmalen und der Vergleichsregel. Daraus folgt keine gesicherte inhaltliche Deutung. Ähnliche Messwerte belegen beispielsweise weder eine gemeinsame Ursache noch einen bestimmten Verwendungszweck. Auch ein rechnerisch klares Ergebnis kann für die eigentliche Frage wenig nützlich sein.
Untersuche die Gruppen deshalb anschließend: Welche Merkmale haben ihre Mitglieder gemeinsam? Gibt es wichtige Unterschiede innerhalb einer Gruppe? Welche zusätzlichen Angaben helfen, eine Vermutung zu prüfen? Ein vorgeschlagener Gruppenname bleibt eine Vermutung, solange die dafür nötigen Informationen fehlen. Fachwissen hilft zu beurteilen, ob die Einteilung sinnvoll ist.
Auch die Auswahl anderer Merkmale, ein anderes Verfahren oder andere Einstellungen können zu anderen Gruppen führen. Ein verändertes Ergebnis belegt für sich genommen weder einen Datenfehler noch die Überlegenheit einer Einteilung. Vergleiche die Ergebnisse mit dem Zweck der Untersuchung und prüfe, welche Deutung die vorhandenen Daten tatsächlich tragen.
Beispiel: Besuche einer digitalen Ausstellung untersuchen (erfundenes Beispiel)
- 1Erfundene Besuche werden anhand ihrer Dauer und der Zahl geöffneter Infoseiten gruppiert.
- 2Eine Gruppe enthält lange Besuche mit vielen geöffneten Seiten.
- 3Der Name „begeisterte Besucher“ ist damit noch nicht belegt. Die Messwerte beschreiben Verhalten, aber nicht sicher das Interesse.
- 4Zusätzliche Angaben, etwa freiwillige Rückmeldungen zum Interesse, könnten helfen, diese Deutung zu prüfen.
Merke: Die Gruppenzuordnung ist ein Untersuchungsergebnis. Ein Gruppenname, eine Ursache oder eine Bewertung braucht eine zusätzliche fachliche Prüfung.
Teste dich
Alles auf einen Blick
Unüberwachtes Lernen
Überwachtes Lernen verwendet vorgegebene Zielangaben; unüberwachtes Lernen sucht ohne solche Zielangaben nach Strukturen.
Clusteranalyse sucht Gruppen, Anomalieerkennung auffällige Datenpunkte und Hauptkomponentenanalyse eine Darstellung mit weniger Größen.
k-Means wechselt zwischen der Zuordnung zum nächsten Zentrum und der Neuberechnung der Mittelwerte.
Die vorher festgelegte Zahl k beeinflusst die Einteilung. Auch Startzentren und ausgewählte Merkmale sind wichtig.
Gefundene Gruppen brauchen eine fachliche Untersuchung. Ihre Zuordnung belegt noch keine Ursache oder Bewertung.
Auffällige Füllstände finden (erfundenes Beispiel)
- 1Aufgabe: Fünf erfundene Behälter haben gemeldete Füllstände von 19, 20, 20, 21 und 60 Zentimetern. Gesucht sind auffällige Einzelwerte, nicht Gruppen.
- 2Wir bestimmen zuerst das gewünschte Ergebnis: Einzelne ungewöhnliche Messungen sollen hervorgehoben werden. Dazu passt die Anomalieerkennung.
- 3Wir vergleichen die Werte: Vier liegen zwischen 19 und 21 Zentimetern. Der Wert von 60 Zentimetern liegt deutlich davon entfernt.
- 4Der Wert von 60 Zentimetern ist deshalb ein naheliegender Kandidat für eine Auffälligkeit. Dieser Vergleich veranschaulicht die Aufgabe; er beschreibt noch kein vollständiges Lernverfahren.
- 5Die Markierung belegt keinen Messfehler. Eine fachliche Prüfung müsste klären, ob der hohe Füllstand tatsächlich vorliegt oder falsch gemeldet wurde.
Fehler finden
Fehler in Zeile 3Die falsche Zeile verwechselt eine Zuordnung nach Maßen mit einer gesicherten Deutung. Richtig: Die Gruppierung allein liefert keine gesicherte Deutung des Verwendungszwecks.
Lückentext
Ein Verfahren übt mit erfundenen Beispielen, bei denen die gewünschte Zielklasse schon eingetragen ist. Es verwendet diese Angaben zum Vorhersagen der Klasse. Das ist Lernen. Gesucht sind Gruppen ähnlicher Datensätze statt Markierungen einzelner ungewöhnlicher Datenpunkte. Dafür passt die . Damit k-Means jedem Punkt das nächste Zentrum zuordnen kann, wird die Zahl der Zentren dieser ersten Zuordnung festgelegt.