

Dateisystem einfach erklärt: Aufbau, Rechte, Auswahl
Du lernst, wie Dateisysteme Dateien ordnen, Daten finden, Zugriffe regeln und zu verschiedenen Speicheraufgaben passen.
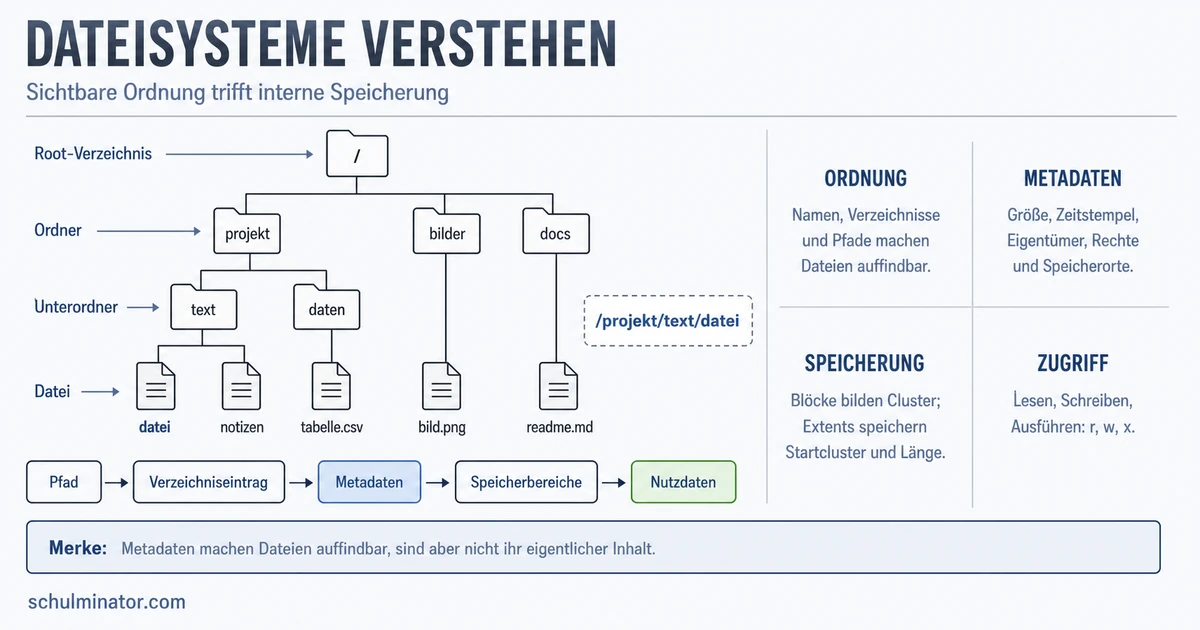
Kurz gesagt
Ein Dateisystem organisiert Dateien und Ordner auf einem Datenträger, also einem Speicher für Daten. Es verwaltet Namen, Speicherorte und weitere Angaben zu Dateien; je nach Dateisystem gehören auch Zugriffsrechte dazu.
Ein Datenträger, etwa eine Festplatte, speichert Daten. Eine Datei fasst gespeicherte Daten unter einem Namen zusammen; ein Ordner enthält Einträge für Dateien und weitere Ordner. Das Dateisystem verbindet diese Ordnung mit den gespeicherten Inhalten. Windows und Linux sind Betriebssysteme: Sie verwalten den Computer und nutzen Dateisysteme für den Zugriff auf Datenträger.
Deine Lernziele
Eine Hierarchie ist eine Ordnung mit übergeordneten und untergeordneten Ebenen. Im einfachen Ordnermodell beginnt sie bei der Wurzel, dem obersten Verzeichnis. Verzeichnis ist ein anderes Wort für Ordner. Ein Ordner kann Unterordner enthalten. Dadurch entsteht eine Struktur wie ein verzweigter Baum.
Ein Pfad beschreibt den Weg zu einem Eintrag. Wir verwenden hier die Schreibweise von Linux: Das Zeichen / trennt die Namen auf dem Weg. Bei /lernen/erde/boden.txt gehst du von der Wurzel über die Ordner „lernen“ und „erde“ zur Datei „boden.txt“. Der Ordner „erde“ enthält diese Datei direkt.
Ein absoluter Pfad beginnt mit / und wird von der Wurzel aus gelesen. Ein relativer Pfad beginnt ohne /; in unseren Beispielen wird er vom aktuellen Ordner aus gelesen. Ist /lernen dein aktueller Ordner, führt erde/boden.txt zur gleichen Datei wie /lernen/erde/boden.txt. Der relative Pfad boden.txt würde dagegen eine Datei direkt in /lernen suchen.
Das Baumbild ist eine Vereinfachung. Ein symbolischer Link ist ein gespeicherter Verweis auf einen anderen Pfad. Solche Verweise können den Weg zu einem anderen Ort weiterleiten.
Pfad
Ein Pfad besteht aus Namen und Trennzeichen. Ein absoluter Linux-Pfad beginnt an der Wurzel; ein relativer Pfad beginnt in unseren Beispielen beim aktuellen Ordner.
Beispiel: Zwei Wege zur erfundenen Datei „plan.txt“
- 1Der aktuelle Ordner ist /freizeit.
- 2Der absolute Pfad lautet /freizeit/zelt/plan.txt.
- 3Der relative Pfad vom aktuellen Ordner lautet zelt/plan.txt.
Teste dich
Der Dateiname ist nicht der Dateiinhalt. Ein Namenseintrag verbindet den Namen innerhalb eines Ordners mit weiteren Informationen zur Datei. Metadaten sind solche Verwaltungsinformationen, zum Beispiel die Dateigröße, der Inhaber und Angaben zur Zuordnung der gespeicherten Daten. Der Inhaber ist der Nutzer, dem die Datei zugeordnet ist.
Für Linux-Dateisysteme wie ext4 betrachten wir ein vereinfachtes Modell: Die Suche arbeitet die Namen eines Pfads nacheinander ab. Der letzte Namenseintrag führt zu einem Inode. Ein Inode ist ein Verwaltungsdatensatz für eine Datei oder einen Ordner. Bei einer gewöhnlichen Datei enthält er unter anderem die Größe und Angaben zur Datenzuordnung. Der vollständige Name und Pfad stehen in diesem Modell nicht im Inode. Die Endung eines Namens, etwa „.txt“, verrät ebenfalls nicht den Speicherort des Inhalts.
Ein Speicherblock ist eine vom Dateisystem verwaltete Speichereinheit auf dem Datenträger. Eine Datei kann mehrere Blöcke belegen. Die Blockzuordnung beschreibt, welche Blöcke zu ihr gehören und in welcher Reihenfolge ihre Inhalte gelesen werden. Der vereinfachte Weg lautet deshalb: Pfad und Namenseintrag → Verwaltungsdatensatz → Blockzuordnung → Dateiinhalt.
Dieser Aufbau ist ein Modell für die beschriebenen Linux-Dateisysteme, kein einheitlicher Bauplan aller Dateisysteme. Nicht jeder Dateiinhalt liegt vollständig in Datenblöcken außerhalb des Inodes: Bei ext4 können die ersten 60 Byte einer Datei direkt im Inode liegen, wenn die entsprechende Funktion eingeschaltet ist und für die Datei verwendet wird. Das heißt Inline-Speicherung. Ein Byte umfasst acht Bit; ein Bit kann den Wert 0 oder 1 haben.
Linux kann die Namenssuche außerdem durch einen Cache beschleunigen, also durch zwischengespeicherte Informationen im Arbeitsspeicher. Der Arbeitsspeicher hält Daten bereit, mit denen laufende Programme arbeiten. Dieser Namens-Cache enthält Namen und Verweise auf Inodes. Die beschriebene Inline-Speicherung legt Dateiinhalte dagegen im Inode ab. Der Namens-Cache ist keine allgemeine Speicherstruktur auf jedem Datenträger.
Metadaten
Metadaten beschreiben und verwalten eine Datei. Dazu gehören beispielsweise ihre Größe und Angaben zur Zuordnung ihrer Daten. Der eigentliche Text einer Textdatei ist dagegen Dateiinhalt.
Beispiel: Die erfundene Datei „teig.txt“ öffnen
- 1Die Suche folgt dem Pfad /rezepte/teig.txt.
- 2Im Ordner „rezepte“ führt der Namenseintrag „teig.txt“ zu einem Verwaltungsdatensatz.
- 3Die dortigen Zuordnungsangaben führen in diesem Beispiel zu Datenblöcken außerhalb des Inodes.
- 4Aus diesen Blöcken wird der gespeicherte Text gelesen.
Teste dich
Für die Blockzuordnung gibt es verschiedene Verfahren. Ein Dateiblock ist ein Abschnitt einer Datei in Blockgröße; der letzte Abschnitt kann weniger Inhalt haben. Eine Einzelblockzuordnung hält für jeden Dateiblock fest, welcher Block auf dem Datenträger dazugehört. Bei ext2 und ext3, zwei Linux-Dateisystemen, können dafür auch weitere Blöcke mit Verweisen nötig sein. Ein Verweis ist hier eine gespeicherte Angabe, wo die Suche weitergeht.
Ein Extent ist dagegen ein Eintrag für einen zusammenhängenden Speicherbereich. Er beschreibt unter anderem dessen Start und Länge. Belegt eine Datei hintereinander die Blöcke 40, 41 und 42, genügt für diesen Bereich die Angabe „Start 40, Länge 3“. Liegen ihre Daten in mehreren getrennten Bereichen, sind mehrere solche Einträge nötig. ext4 kann diese Einträge in einer verzweigten Suchstruktur verwalten. Das Beispiel erklärt die Zuordnung; es beweist keine allgemeine Geschwindigkeitsaussage.
Für Rechte betrachten wir das einfache Unix-Modell. Unix bezeichnet eine Familie von Betriebssystemen; Linux verwendet ebenfalls dieses Rechtemodell. Es unterscheidet Inhaber, Gruppe und alle anderen. Eine Gruppe fasst Nutzer zusammen. Für jede Datei ist eine Gruppe eingetragen. Im einfachen Modell gilt die Inhaber-Kategorie für den Inhaber, sonst die Gruppen-Kategorie für einen Nutzer dieser Gruppe und sonst die Kategorie „alle anderen“. Die Rechte dieser drei Kategorien werden dabei nicht einfach addiert.
Die Rechte Lesen, Schreiben und Ausführen haben bei Dateien und Ordnern unterschiedliche Aufgaben. Eine geeignete Datei auszuführen bedeutet, sie als Programm zu starten. Bei einem Ordner bedeutet Ausführen, ihn auf einem Zugriffsweg betreten und darin Einträge über ihren Namen erreichen zu dürfen. Das Auflisten der Namen ist dagegen eine Aufgabe des Leserechts.
Zum Anlegen oder Entfernen eines Eintrags braucht ein gewöhnlicher Nutzer Schreibrecht und Ausführrecht am betreffenden Ordner; auch der Weg dorthin muss zugänglich sein. Schreibrecht an der Datei betrifft ihren Inhalt und erteilt für sich kein Löschrecht am Ordnereintrag. Weitere Schutzregeln können Zugriffe trotzdem verhindern. Beispielsweise kann ein Datenträger schreibgeschützt eingebunden sein, also nur zum Lesen bereitstehen. Eine Datei kann zusätzlich gegen Änderungen geschützt sein. Die besondere Ordnerschutzregel Sticky Bit kann gewöhnlichen Nutzern das Entfernen oder Umbenennen fremder Einträge verbieten, wenn sie weder Inhaber der Datei noch des Ordners sind.
| Verfahren | Gespeicherte Zuordnung |
|---|---|
| Einzelblockzuordnung | Zu jedem Dateiblock wird der zugehörige Speicherblock festgehalten. |
| Bereichszuordnung mit Extents | Ein Eintrag beschreibt einen zusammenhängenden Bereich durch Start und Länge. |
| Recht | Bei einer Datei | Bei einem Ordner |
|---|---|---|
| Lesen | Den Inhalt lesen | Die enthaltenen Namen auflisten |
| Schreiben | Den Inhalt ändern | Mit Ausführrecht Einträge anlegen oder entfernen; weitere Schutzregeln können sperren. |
| Ausführen | Eine geeignete Datei als Programm starten | Den Ordner auf einem Zugriffsweg betreten und benannte Einträge erreichen |
Merke: Dateiinhalt und Ordnereintrag sind zu unterscheiden. Die einfachen Rechte gelten zusammen mit dem zugänglichen Pfad und möglichen weiteren Schutzregeln.
Teste dich
FAT32, exFAT und NTFS sind verschiedene Dateisysteme. FAT steht für File Allocation Table, auf Deutsch Dateizuordnungstabelle; FAT32 ist der Name einer Variante. exFAT bedeutet Extended File Allocation Table, also erweiterte Dateizuordnungstabelle. NTFS steht für New Technology File System, also Dateisystem neuer Technologie. Diese Namen allein sagen noch nicht, welches Format zu einem Gerät passt.
Für die Auswahl prüfst du den Zweck, die Größe einzelner Dateien und die von allen beteiligten Geräten unterstützten Formate. GiB bedeutet Gibibyte und ist eine Einheit für Datenmengen. Ein GiB umfasst 1.073.741.824 Byte. Die bereitgestellte Microsoft-Vergleichstabelle nennt bei FAT32 eine Dateigrößengrenze von 4 GiB. Dateien deutlich darüber, etwa mit 6 GiB, passen deshalb nicht hinein. Eine bytegenaue Grenzfallentscheidung leiten wir daraus nicht ab. exFAT und NTFS erlauben deutlich größere Einzeldateien; die konkreten Grenzen hängen auch von der Umsetzung im jeweiligen System ab.
FAT32 und exFAT bieten keine eigenen Zugriffslisten für einzelne Dateien. NTFS bietet solche Listen: Sie legen fest, welche Nutzer welche Zugriffe erhalten. Diese Listen sind vom zuvor erklärten einfachen Unix-Rechtemodell zu unterscheiden. NTFS besitzt außerdem ein Journal für Metadaten. Ein Journal ist ein Protokoll, das Änderungen vor ihrer endgültigen Übernahme festhält. Das hilft nach einem Absturz beim Wiederherstellen eines geordneten Zustands. Ein Metadaten-Journal garantiert aber nicht die Rettung jedes Dateiinhalts.
Eine Partition ist ein abgegrenzter Bereich eines Datenträgers. Wir betrachten einen Windows-Aufbau mit einer EFI-Systempartition zum Starten und einer getrennten Windows-Partition. EFI steht für Extensible Firmware Interface und bezeichnet eine Schnittstelle für den Systemstart. In diesem Aufbau braucht die EFI-Systempartition FAT32 und die Windows-Partition NTFS. Ein Format für eine dieser Partitionen lässt sich deshalb nicht einfach auf die andere übertragen.
Für Linux-Datenpartitionen ist ext4 eine übliche zusätzliche Wahl. Es kann ein Journal nutzen; diese Funktion lässt sich auch abschalten. Linux ist jedoch nicht auf ext4 beschränkt. Ein Treiber ist ein Programmteil, der dem Betriebssystem den Umgang mit einem Format oder Gerät ermöglicht. Der hier beschriebene NTFS3-Treiber ermöglicht Linux das Lesen und Schreiben von NTFS. Beim beschriebenen Stand unterstützt er das erneute Anwenden vorhandener Journal-Einträge, aber noch keine vollständige Journal-Unterstützung. Das Merkmal des Dateisystems und die Fähigkeiten eines bestimmten Treibers sind also getrennt zu prüfen.
| Format | Wichtige Eigenschaft | Passender vorgegebener Fall |
|---|---|---|
| FAT32 | Keine Einzeldateien deutlich über 4 GiB; keine eigenen Dateizugriffslisten | Kleine Dateien auf einem Stick, wenn das Zielgerät FAT32 verlangt |
| exFAT | Große Einzeldateien möglich; keine eigenen Dateizugriffslisten | Austausch großer Dateien, wenn alle beteiligten Geräte exFAT unterstützen |
| NTFS | Eigene Zugriffslisten und Journal für Metadaten | Die Windows-Partition im beschriebenen Windows-Aufbau |
| ext4 | Für Linux-Datenpartitionen üblich; Journal abschaltbar | Eine eigene Linux-Datenpartition |
Beispiel: Ein erfundener Stick für ein Ausstellungsgerät
- 1Das Ausstellungsgerät kann laut Vorgabe auf dem Stick ausschließlich FAT32 lesen.
- 2Alle zu übertragenden Dateien sind kleiner als 1 GiB.
- 3FAT32 passt zu diesen Vorgaben. Unterstützung für exFAT oder NTFS ist für dieses Gerät nicht gegeben.
Merke: Die Unterstützung des Zielgeräts gehört zur Aufgabe. Aus dem Anschluss eines USB-Sticks folgt keine Zusage, dass das Gerät jedes Dateisystem versteht. USB bezeichnet hier die verbreitete Verbindung zwischen Computer und angeschlossenem Gerät.
Teste dich
Alles auf einen Blick
Dateisystem
Ordner und Unterordner bilden im einfachen Modell einen Baum; symbolische Links können zu anderen Pfaden weiterführen.
Ein absoluter Linux-Pfad beginnt an der Wurzel, ein relativer Pfad in unseren Beispielen am aktuellen Ordner.
Im beschriebenen Linux-Modell führt der Namenseintrag zum Verwaltungsdatensatz und dessen Angaben zu den Daten. Bei genutzter Inline-Speicherung können die ersten 60 Byte direkt im Inode liegen.
Einzelne Blöcke lassen sich getrennt zuordnen; Extents beschreiben zusammenhängende Bereiche durch Start und Länge.
Im einfachen Unix-Modell sind Rechte am Dateiinhalt von Rechten am Ordnereintrag zu unterscheiden; zusätzliche Schutzregeln können Zugriffe sperren.
Zweck, Einzeldateigröße und Geräteunterstützung entscheiden gemeinsam über ein passendes Dateisystem.
Eine erfundene Datei vom Pfad bis zu den Daten verfolgen
- 1Gegeben ist ein vereinfachtes Linux-Modell: Der Inhalt der Datei /wetter/mai/wolken.bin liegt in Datenblöcken außerhalb ihres Inodes.
- 2Der Pfad beginnt mit /. Die Suche startet deshalb an der Wurzel und folgt den Ordnern „wetter“ und „mai“.
- 3Im Ordner „mai“ führt der Namenseintrag „wolken.bin“ zum Inode, dem Verwaltungsdatensatz der Datei.
- 4Die Blockzuordnung nennt für die Datei in diesem Beispiel einen Bereich mit Start 83 und Länge 2.
- 5Dieser Bereich umfasst die Blöcke 83 und 84. Ihre Inhalte werden in dieser Reihenfolge als Dateiinhalt gelesen.
Fehler finden
Fehler in Zeile 3Die Aussage verwechselt das Ändern des Dateiinhalts mit dem Entfernen des Ordnereintrags. Richtig: Ben darf den Inhalt ändern, aber den Eintrag nicht entfernen, weil ihm das Schreibrecht am Ordner fehlt.
Lückentext
Ein Linux-Pfad beginnt mit / und wird von der Wurzel aus gelesen. Er ist . Ein zusammenhängender Bereich umfasst die Blöcke 27, 28 und 29. Sein Bereichseintrag hat die Länge . Im einfachen Unix-Modell hat ein gewöhnlicher Nutzer an einer Datei Leserecht, aber kein Schreibrecht. Der ganze Zugriffsweg ist zugänglich; weitere Sperren gibt es nicht. Er darf ihren Inhalt .